2026-10 개정: 이 글은 지금의 Plit 에 맞춰 다시 썼다. 1:1 캐릭터 챗만 남으면서 Target Resolution 단계와 Redis 기반 provider 전환이 사라졌고, 컨텍스트 빌드와 병렬 입력 심사, 용도별 모델 배정, 화면 도달량 기준 환불로 바뀐 구조를 반영했다.
도입
Plit은 AI 캐릭터와 1:1 로 대화하는 AI 채팅 플랫폼이다. 사용자는 캐릭터를 골라 그 캐릭터의 페르소나만으로 대화하고, 대화가 쌓이면 호감도에 따라 말투와 태도가 변한다. 그룹 챗은 아직 계획 단계다.
상대가 한 명이어도 모델 호출 한 번으로 끝나지 않는다. 이 사용자와 이 캐릭터 사이에 무엇이 있었는지 찾아 오고, 그걸 바탕으로 대사를 만들어 흘려보내고, 그 대사를 보고 호감도를 어떻게 바꿀지 평가해야 한다. 그사이에 입력이 안전한지도 따로 판정한다.
사용자가 메시지 하나를 보내면 백엔드에서는 컨텍스트 빌드 → 응답 생성(스트리밍) → 턴 마무리 3단계가 돈다. 이 글은 그 파이프라인의 구조와 스트리밍 처리 방식을 실제 코드로 기록한다.
아키텍처 개요
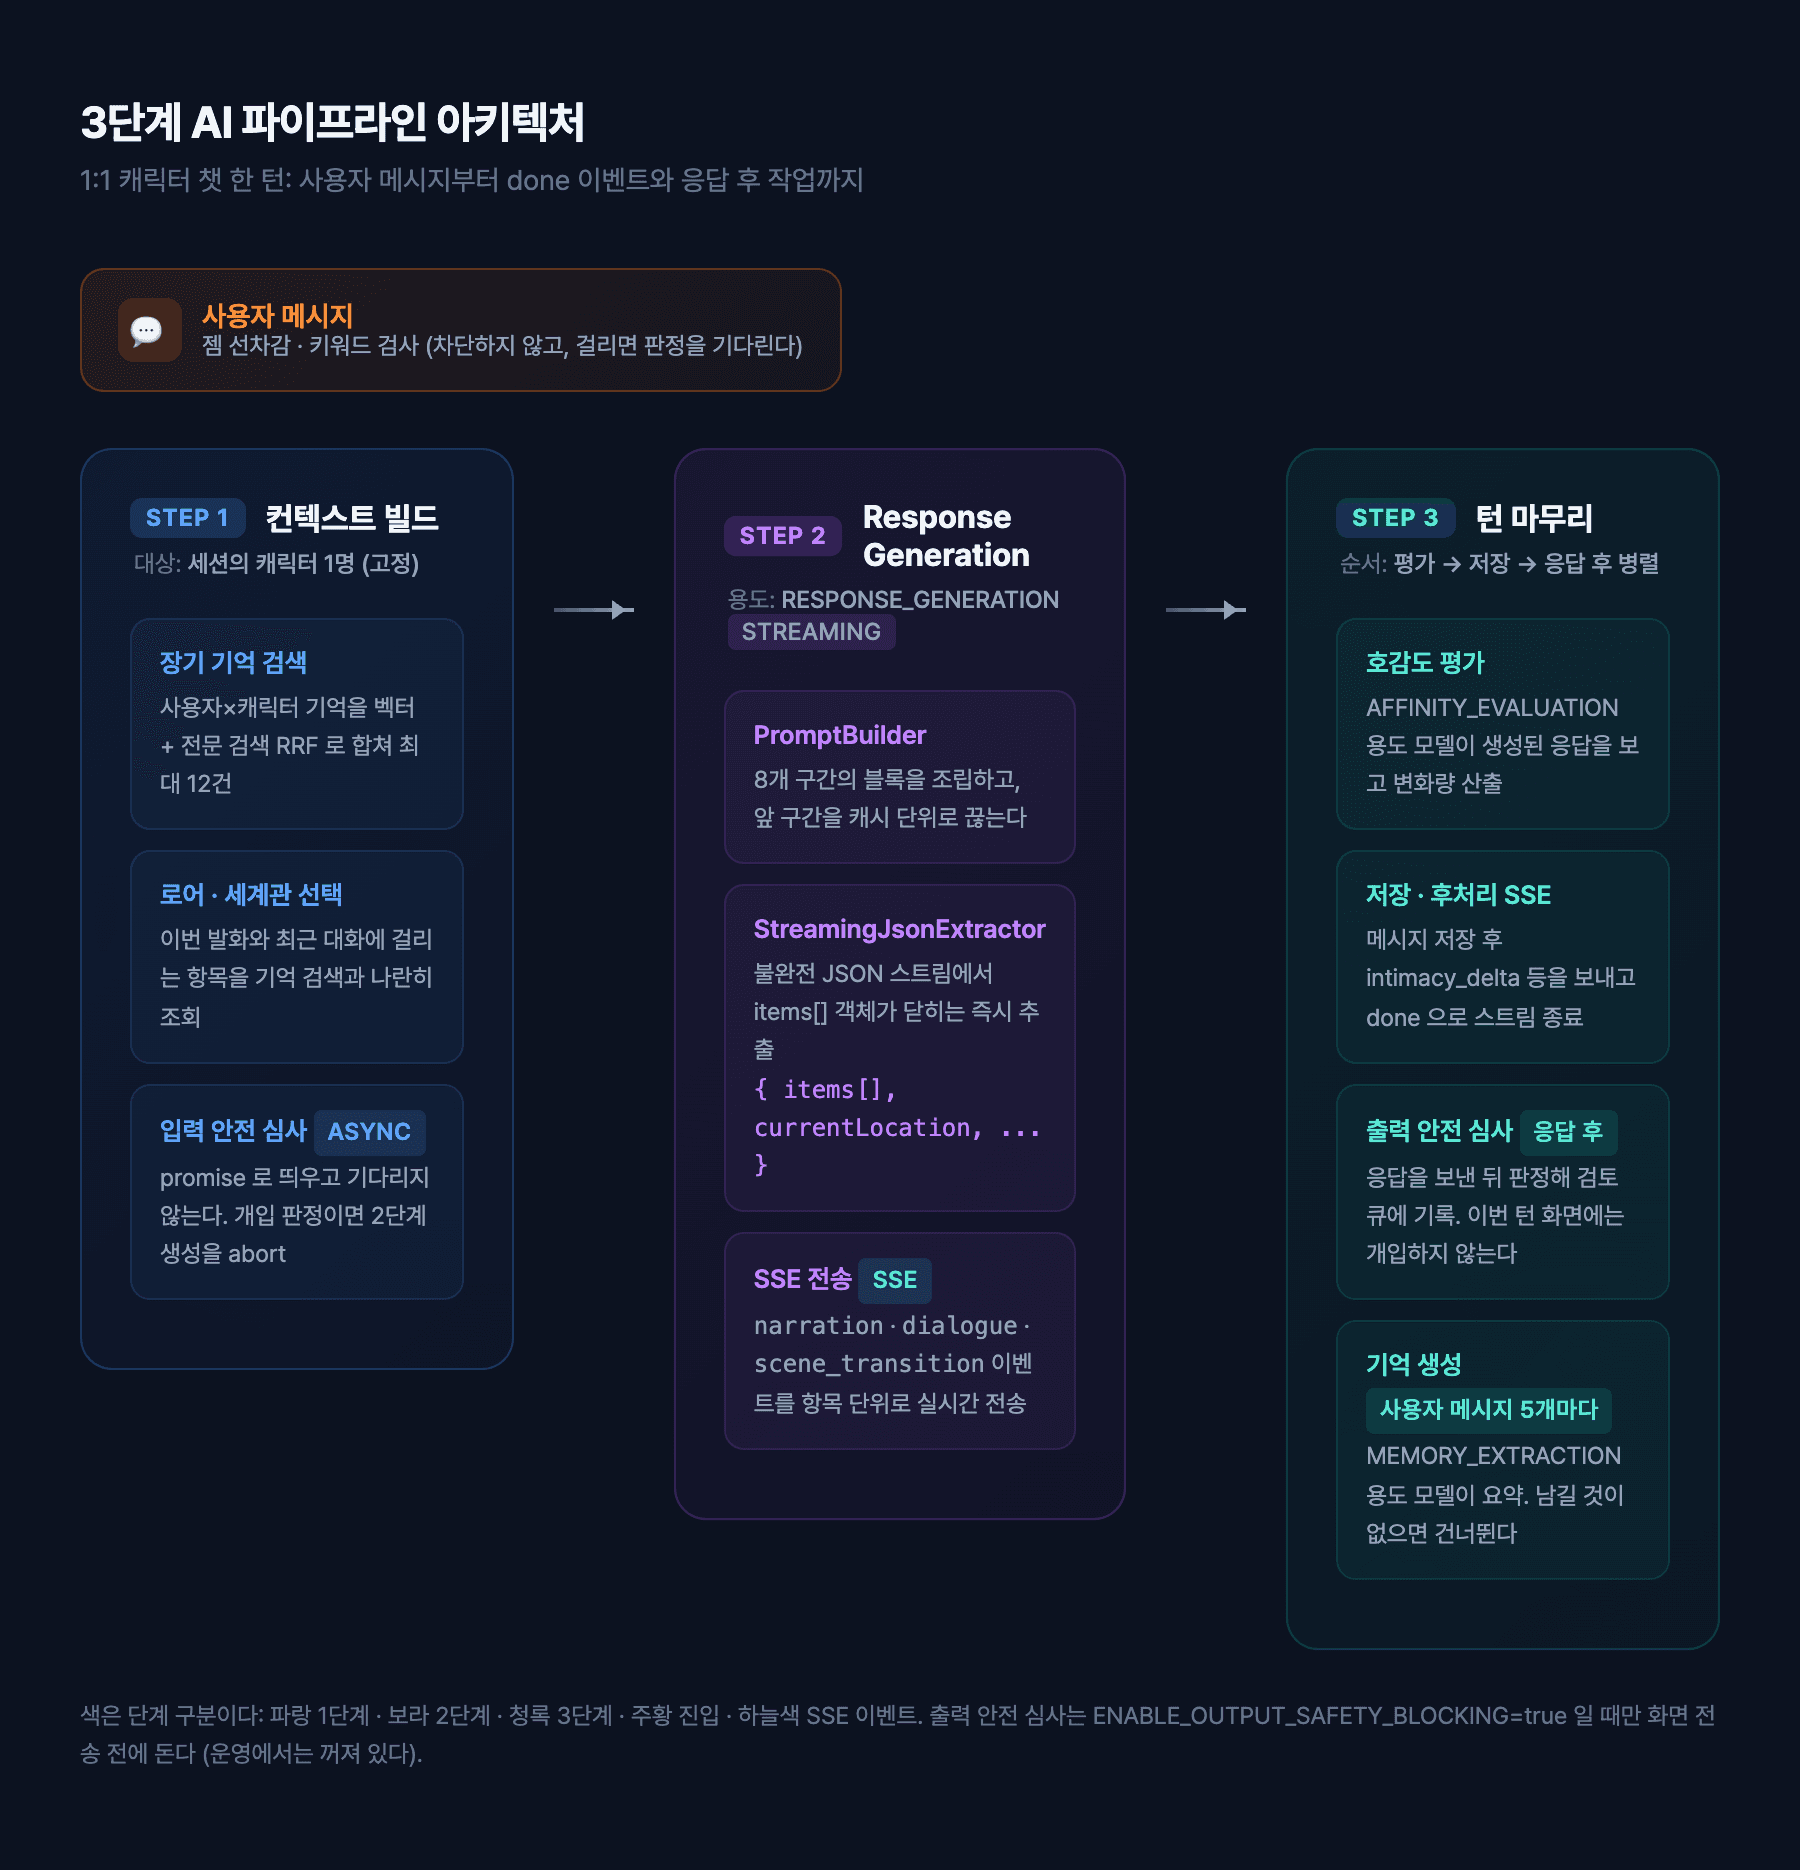
파이프라인의 진입점은 AiPipelineService.runStream() 하나다. 동기 버전은 없다.
// backend/src/ai-pipeline/ai-pipeline.service.ts (요약)
async runStream(
  context: PipelineContext,
  onItem: (item: GeneratedItem) => void,
): Promise<PipelineResult> {
  // 1단계: 기억 검색·로어 선택, 입력 안전 심사는 promise 로 띄워만 둔다
  const genContext = await this.buildGenerationContext(context);

  // 2단계: 응답 생성 (스트리밍). 입력 판정이 개입을 요구하면 safetyAbort 로 끊는다
  const result = await this.executeWithRetry(
    genContext.context,
    emit,
    safetyAbort.signal,
  );

  // 3단계: 호감도 평가 + 메타데이터 정리
  return this.evaluateAndFinalize(context, genContext, result);
}
onItem 콜백이 핵심이다. 응답을 만드는 도중 나레이션이나 대사가 하나씩 완성될 때마다 호출되므로, 호출부는 전체 응답을 기다리지 않고 SSE 로 바로 흘려보낸다.
파이프라인 바깥의 일은 ChatTurnService(backend/src/chat/chat-turn.service.ts)가 맡는다. 젬 선차감, 키워드 검사, 파이프라인 호출, 저장, 후처리 SSE, 응답 후 작업, 실패 시 환불까지가 한 턴이다. 컨트롤러는 SSE 헤더를 세팅하고 응답 객체를 넘기기만 한다.
핵심 1: 컨텍스트 빌드
대답할 캐릭터는 이미 정해져 있다
세션은 character_chat_id 하나에 매달리고, 그 채팅의 상대는 캐릭터 한 명이다. 그래서 "누가 대답할지"는 판단할 문제가 아니다.
// backend/src/ai-pipeline/ai-pipeline.service.ts: buildGenerationContext 내부
targetCharacterName = context.characters[0].name;
targetCharacterId = nameToId.get(targetCharacterName) ?? null;
초기에는 여러 캐릭터가 한 장면에 등장하는 모드가 있어서, 경량 모델로 응답할 캐릭터를 고르는 Target Resolution 단계가 따로 있었다. 1:1 캐릭터 챗으로 좁히면서 그 단계는 대입문 한 줄이 됐다. 단계를 나눠 두었기 때문에 필요 없어진 단계를 통째로 걷어내는 것도 쉬웠다.
기다리는 일과 기다리지 않는 일
대상이 고정되면 남는 일은 이번 턴에 실을 재료를 모으는 것이다. 이 단계에서 서로 의존하지 않는 일은 나란히 띄운다.
- 장기 기억 검색: 기억은 세션이 아니라 사용자×캐릭터 쌍에 쌓인다. 벡터 검색과 전문 검색 결과를 RRF 로 합치고, 한 턴에 최대 12건을 싣는다. 그중 2자리는 검색 순위와 무관하게 중요도가 높은 기억에 예약돼 있다.
- 로어 선택: 이번 발화와 최근 대화에서 걸리는 세계관 항목을 고른다. DB 왕복 한 번이라 기억 검색 대기 시간에 묻힌다.
- 입력 안전 심사: 심사기는 생성과 같은 장기 기억을 봐야 해서 기억 검색이 끝난 뒤 띄운다. 다만 결과를 기다리지 않고 promise 로만 넘긴다.
// backend/src/ai-pipeline/ai-pipeline.service.ts: buildGenerationContext 내부
const inputSafetyPromise = this.contentSafetyEvaluation
  .evaluateInput(safetyParams)
  .catch((err: unknown) => {
    this.logger.error(`Input safety evaluation threw: ${String(err)}`);
    return {
      decision: 'APPROVE',
      reason: 'Safety evaluation failed',
    } as SafetyEvalResult;
  })
  .then(withNormalizedCategory);
심사를 기다린 뒤 생성을 시작하면 매 턴 첫 글자가 심사 시간만큼 늦어진다. 그래서 생성과 심사를 동시에 돌리고, 판정이 개입을 요구하면 그때 생성 스트림을 AbortController 로 끊는다. 생성이 판정보다 먼저 끝나 버리는 턴도 있으니, 생성이 끝난 뒤에 판정을 한 번 더 확인한다. 이 확인이 없으면 빠른 턴만 심사를 통과하는 경주가 된다.
예외는 키워드 블랙리스트에 걸린 턴이다. 키워드는 문맥을 못 보므로 스스로 차단하지 않는다. 대신 그 턴만 생성을 시작하기 전에 문맥을 아는 LLM 심사기의 판정을 기다린다(awaitInputSafety). 판정이 무엇을 뜻하는지는 resolveSafetyAction() 한 곳에서 정한다. 심사가 실패하면 승인으로 떨어지는 fail-open 이 기본이다.
핵심 2: Response Generation + Streaming
컨텍스트가 모이면 응답 생성이 시작된다. 파이프라인에서 가장 무거운 단계이고, 사용자가 느끼는 지연의 대부분이 여기서 나온다.
시스템 프롬프트 구축
PromptBuilder는 프롬프트를 블록 단위로 조립한다. 블록 id 마다 렌더러가 하나씩 있고, 블록은 8개 구간으로 묶인다.
// backend/src/ai-pipeline/services/prompt-builder.ts (발췌)
private static readonly BLOCK_RENDERERS = {
  // ① 서비스 골격
  'director/mode': (b) => b.renderDirectorMode(),
  'safety/content-rating': (b) => b.renderContentRating(),
  // ② 캐릭터 정체성
  'character/profiles': (b) => b.renderCharacterProfiles(),
  // ③ 관계와 상태
  'affinity/level-guide': (b) => renderAffinityLevelGuide(b.sections),
  // ⑥ 참고 데이터와 그 한계
  'memory/recalled': (b) => b.renderMemories(),
  // ⑦ 대화 기록
  'chat/history': (b) => b.renderRecentHistory(),
  // ⑧ 최종 지시
  'output/format': (b) => b.renderOutputFormat(),
  // ...
};
순서는 코드에 박혀 있지 않다. 어드민이 바꾼 순서를 PromptBlockConfigService가 검증해서 넘기고, 조립기는 받은 순서대로 렌더링만 한다.
buildSegments()는 같은 프롬프트를 캐시 단위로 끊어 낸다. 이어 붙이면 한 글자도 다르지 않고, 끊는 자리만 정한다. 어느 캐릭터든 같은 서비스 골격(①)과 캐릭터마다 고정인 정체성(②)을 앞에 두고 구간마다 끊어서, 프로바이더가 그 경계를 프롬프트 캐시 중단점으로 쓴다. 로어가 바뀐 턴에도 ①은 캐시에서 읽힌다.
호감도는 레벨별 행동 지침으로
호감도 레벨은 -1, 1, 2, 3, 4, 5 여섯 단계다(0 은 없다). 프롬프트에는 현재 레벨과 점수도 실리지만, 캐릭터의 태도를 실제로 정하는 것은 레벨마다 붙은 행동 지침 문장이다.
// packages/shared/src/affinity-config.ts (발췌)
export const AFFINITY_LEVEL_GUIDES: Record<number, string> = {
  [1]: '거리를 두되 차갑지는 않다. 상대가 말을 걸면 짧게 답하고, 호기심이 생기면 조심스럽게 티를 낸다. 먼저 나서지 않지만 대화를 이어가려는 기색은 있다.',
  [2]: '경계를 낮추고 자연스럽게 대화한다. 가벼운 농담을 섞고, 서투른 모습을 숨기지 않으며, 상대의 일상에 소소한 관심을 보인다.',
  // ...
};
캐릭터가 특정 레벨의 호칭과 태도를 다시 정의했다면(affinityLevelOverrides) 그 문장이 전역 지침을 대신한다.
프롬프트에는 이 밖에도 장기 기억, 사용자 노트, 캐릭터별 사용자 팩트, 직전 턴의 내면 상태, 최근 대화가 함께 들어간다. 최근 대화는 메시지 개수가 아니라 사용자 메시지 기준 최근 6턴을 자른다. 그보다 오래된 맥락은 장기 기억이 맡는다.
JSON 스트리밍과 StreamingJsonExtractor
AI 응답은 이런 JSON 구조로 온다. 형식은 프롬프트의 output/format 블록이 지시한다.
{
  "items": [
    {"type": "narration", "text": "묘한 침묵이 흘렀다."},
    {"type": "dialogue", "character": "한시우", "text": "(시선을 피하며) ...뭐야, 왜 조용해."}
  ],
  "currentLocation": "학교 옥상",
  "characterStates": {
    "한시우": {"mood": "불안", "thinking": "뭔가 이상한데..."}
  },
  "emotionCode": "shy",
  "sceneCode": "school"
}
items의 type은 narration, dialogue, scene_transition 셋 중 하나다. emotionCode와 sceneCode는 닫힌 코드 목록에서 정확히 하나를 고르게 하는 필드이고, 목록 밖 값은 버린 뒤 턴 메타데이터에 원문과 함께 남긴다.
문제는 도착 방식이다. 이 JSON은 한 번에 오지 않고 토큰 단위로 쪼개져 들어오며, items 배열 안의 객체가 하나씩 완성될 때마다 사용자에게 내보내야 한다.
그래서 StreamingJsonExtractor를 만들었다. 핵심은 중괄호 깊이 추적이다.
// backend/src/ai-pipeline/utils/streaming-json-extractor.ts (요약)
export class StreamingJsonExtractor<T = unknown> {
  private buffer = '';
  private depth = 0;
  private itemStart = -1;
  private inString = false;   // 문자열 내부 중괄호 무시
  private escaped = false;    // 이스케이프 시퀀스 처리
  private arrayFound = false;
  private cursor = 0;         // 이미 처리한 위치: 재스캔 방지

  feed(chunk: string): T[] {
    this.buffer += chunk;
    const items: T[] = [];

    // "items": [ 패턴을 찾아 배열 시작 위치 확정
    if (!this.arrayFound) {
      const pattern = new RegExp(
        `"${this.escapeRegex(this.arrayKey)}"\\s*:\\s*\\[`,
      );
      const match = this.buffer.match(pattern);
      if (!match) return [];
      this.arrayFound = true;
      this.cursor = this.buffer.indexOf(match[0]) + match[0].length;
    }

    for (let i = this.cursor; i < this.buffer.length; i++) {
      const ch = this.buffer[i];
      if (this.escaped) { this.escaped = false; continue; }
      if (ch === '\\' && this.inString) { this.escaped = true; continue; }
      if (ch === '"') { this.inString = !this.inString; continue; }
      if (this.inString) continue;

      if (ch === '{') {
        if (this.depth === 0) this.itemStart = i;
        this.depth++;
      } else if (ch === '}') {
        this.depth--;
        if (this.depth === 0 && this.itemStart !== -1) {
          // 완전한 객체 하나 완성 → JSON.parse 후 반환 (깨진 객체는 건너뛴다)
          try {
            items.push(JSON.parse(this.buffer.slice(this.itemStart, i + 1)) as T);
          } catch {}
          this.itemStart = -1;
        }
      }
    }
    this.cursor = this.buffer.length;
    return items;
  }
}
설계에서 챙긴 것은 세 가지다.
- cursor로 재스캔 방지:
feed()가 불릴 때마다 이전에 처리한 위치 다음부터만 훑는다. - 문자열 컨텍스트 인식:
inString플래그로 JSON 문자열 안의{,}를 무시한다."text": "그가 {웃으며} 말했다"같은 값도 깨지지 않는다. - 이스케이프 시퀀스:
\"처럼 이스케이프된 따옴표를 문자열 종료로 잘못 읽지 않게 막는다.
ResponseGenerationService에서 쓰는 흐름은 이렇다.
// backend/src/ai-pipeline/services/response-generation.service.ts: generateStream 내부
const extractor = new StreamingJsonExtractor<Record<string, unknown>>('items');

const handleTextDelta = (textDelta: string) => {
  fullText += textDelta;
  const newItems = extractor.feed(textDelta);
  const normalized = ResponseGenerationService.normalizeItems(
    newItems,
    context.targetCharacterName,
  );
  // 완성된 항목마다 즉시 콜백 호출
  for (const item of normalized) {
    onItem(item);
    sentItemCount++;
  }
};
스트리밍이 끝나면 전체 텍스트를 다시 파싱하고, 스트림 도중 포착하지 못한 항목이 있으면 sentItemCount 이후부터 마저 보낸다. JSON 이 잘려 파싱에 실패하면 같은 StreamingJsonExtractor를 새로 하나 만들어 완성된 항목만이라도 복구한다.
재시도는 첫 항목이 나가기 전까지만
생성이 실패하면 다시 시도한다. 다만 조건이 있다.
// backend/src/ai-pipeline/ai-pipeline.service.ts: executeWithRetry 내부
if (err.sentItemCount > 0) {
  this.logger.warn(
    `Generation failed after ${err.sentItemCount} items sent: cannot retry`,
  );
  throw err;
}
시도는 최대 2번, 시도당 15초, 전체 25초로 묶여 있다. 이미 한 항목이라도 화면에 나갔다면 재시도하지 않는다. 다시 생성한 응답은 앞서 보낸 대사와 이어지지 않기 때문이다. 같은 원칙이 모델 폴백에도 걸린다. 아래에서 다룬다.
핵심 3: 모델은 코드가 아니라 용도 배정이 정한다
호출부는 모델 이름을 모른다. 용도만 넘긴다.
// backend/src/ai-pipeline/services/response-generation.service.ts: generateStream 내부
const req = {
  task: LlmTask.RESPONSE_GENERATION,
  modelId: context.llmModelId,
  maxTokens: 4096,
  system: systemSegments,
  userMessage: context.userMessage,
  responseFormat: 'json' as const,
  operation: 'generate-response',
};
어느 모델이 그 용도를 맡을지는 DB 의 llm_task_assignments가 정하고, 어드민 화면에서 바꾼다. 새 모델은 llm_models 테이블에 행을 추가하면 배포 없이 쓸 수 있다. 한 턴 안에서 쓰이는 용도는 이렇다.
용도 (LlmTask) | 하는 일 | 언제 |
|---|---|---|
RESPONSE_GENERATION | 대사·나레이션 생성 | 2단계, 스트리밍 |
CONTENT_SAFETY | 입력·출력 안전 판정 | 입력은 생성과 병렬, 출력은 응답 후 |
AFFINITY_EVALUATION | 호감도 변화량 평가 | 3단계, 생성된 응답을 본 뒤 |
MEMORY_EXTRACTION | 장기 기억 추출·요약 | 응답 후, 사용자 메시지 5개가 쌓일 때마다 (남길 것이 없으면 건너뛴다) |
응답 생성만 예외적으로 사용자가 채팅방에서 모델을 직접 고를 수 있다. 그래서 AiClientService는 사용자 선택을 먼저 보고, 없으면 용도 배정을 따른다.
// backend/src/common/ai-client/ai-client.service.ts
async resolveModel(req: AiTextRequest): Promise<ResolvedLlmModel> {
  const chosen = await this.registry.resolveUserChoice(req.modelId);
  if (chosen && chosen.modality === 'TEXT') return chosen;
  return this.registry.resolveForTask(req.task);
}
배정 행에는 폴백 모델을 최대 3개까지 둘 수 있다. 스트림에서는 첫 조각이 나가기 전에 실패했을 때만 다음 후보로 다시 연다. 한 조각이라도 나간 뒤에는 바꾸지 않는다. 받는 쪽 화면에 앞 모델의 글이 이미 있기 때문이다. 콘텐츠 거부는 입력에 대한 신호라 다른 프로바이더로 우회하지 않는다.
모델을 용도 단위로 나눠 두면, 비싼 창작 모델과 가벼운 판정 모델을 각각 따로 바꿀 수 있고, 그 교체가 코드 배포를 거치지 않는다.
핵심 4: POST-based SSE
왜 네이티브 EventSource를 쓰지 않는가
브라우저의 EventSource API는 GET 요청만 지원한다. 그런데 Plit의 메시지 전송에는 content(최대 2000자)를 비롯한 본문이 따라붙는다. GET 쿼리 파라미터에 실어 보내기에는 맞지 않는다.
그래서 POST 요청에 res.write() 수동 SSE를 얹었다.
백엔드: SSE 이벤트 구조
이벤트 이름은 백엔드와 프론트가 같이 보는 @plit/shared에 있다. 한 턴에 쓰이는 것만 추리면 이렇다.
// packages/shared/src/sse-events.ts (발췌)
export const SSE_EVENTS = {
  NARRATION: 'narration',
  DIALOGUE: 'dialogue',
  SCENE_TRANSITION: 'scene_transition',
  AFFINITY_DELTA: 'intimacy_delta',
  LOCATION_CHANGE: 'location_change',
  CONVERSATION_PAUSE: 'conversation_pause',
  DIALOGUE_CUT: 'dialogue_cut',
  DONE: 'done',
  ERROR: 'error',
  // ... 기기 간 동기화, 세션 공유 이벤트
} as const;
AFFINITY_DELTA의 키와 값이 다른 것은 이벤트 이름이 클라이언트와의 계약이라서다. 웹과 앱이 새 이름을 받도록 배포되기 전에 값을 바꾸면 그 배포 시차 동안 델타가 조용히 유실된다. 그래서 코드 쪽 이름은 AFFINITY_DELTA로 두고, 전송 값은 클라이언트가 새 이름을 받게 된 뒤에 바꾼다.
컨트롤러는 SSE 헤더를 세팅하고 턴 실행을 넘긴다.
// backend/src/chat/chat.controller.ts: sendMessage 내부 (요약)
res.setHeader('Content-Type', 'text/event-stream');
res.setHeader('Cache-Control', 'no-cache');
res.setHeader('Connection', 'keep-alive');
return this.chatTurn.run(
  { sessionId, userId, content, mentionedCharacter, forceAdvanceEvent, clientId },
  res,
);
ChatTurnService는 Express 를 모르고 write와 end만 있는 sink 를 받는다. 이벤트 하나는 헬퍼 하나로 직렬화한다.
// backend/src/chat/turn-sse.ts
export function sseFrame(event: string, data: unknown): string {
  return `event: ${event}\ndata: ${JSON.stringify(data)}\n\n`;
}
생성된 항목은 narration, scene_transition, dialogue 이벤트로 그 즉시 나간다. 파이프라인이 끝나면 호감도 변화(intimacy_delta), 장소 변경, 대화 일시정지 같은 후처리 이벤트가 이어지고, 마지막에 done이 저장된 메시지 id, 젬 잔액, 호감도 등을 싣고 스트림을 닫는다. 프론트엔드는 done을 받는 순간 스트림 소비를 멈춘다.
항목은 소켓에 바로 쓰지 않고 TurnOutputGate를 거친다. 기본은 받은 즉시 내보내는 통로다. 출력 안전 심사는 응답을 보낸 뒤에 돌고 이번 턴의 화면에는 개입하지 않기 때문이다. 게이트가 항목을 붙잡는 경우는 둘이다. ENABLE_OUTPUT_SAFETY_BLOCKING=true일 때(운영에서는 꺼져 있다)와, 키워드에 걸려 입력 판정을 기다리는 턴이다. 생성 도중 항목마다 블랙리스트 검사도 하는데, CRITICAL 카테고리 키워드가 나온 문장만 고정 나레이션으로 바꾸고 나머지는 로그만 남긴다.
에러 처리와 재화 롤백
젬은 턴을 시작할 때 선차감한다. 실패하면 되돌리는데, 기준은 예외의 종류가 아니라 화면에 실제로 도달한 항목 수다.
// backend/src/chat/turn-failure.ts
export function classifyTurnFailure(
  error: unknown,
  flushedItemCount: number,
): TurnFailureKind {
  // 제공사 하드 차단은 아무것도 저장되지 않은 턴 실패다. 흘러간 항목 수와 무관하게 환불한다
  if (error instanceof ProviderBlockedError) {
    return 'complete_failure';
  }
  if (error instanceof RetryableGenerationError && error.sentItemCount > 0) {
    return 'generation_partial';
  }
  if (flushedItemCount > 0) {
    return 'response_save_failed';
  }
  return 'complete_failure';
}
환불은 complete_failure만 한다. 응답이 일부라도 화면에 닿았다면 젬을 유지하고, error 이벤트에 그 사실을 담아 보낸다. 예외 타입만 보고 판정하면, 응답을 다 보낸 뒤 저장에서 터진 실패가 완전 실패로 처리돼 받은 응답까지 공짜가 된다.
환불 자체는 차감 거래 ID 하나로 원래 빠져나간 로트에 그대로 돌려놓는 refundSpend가 맡는다.
// backend/src/chat/chat-turn.service.ts
private async issueRefundOnce(
  state: TurnState,
): Promise<{ gemRefunded: boolean; error?: unknown }> {
  // 테스트 턴, 혹은 아직 차감이 일어나기 전 실패는 환불할 것이 없다
  if (
    !state.wallet?.gemTransactionId ||
    state.refundIssued ||
    state.isTestSession
  ) {
    return { gemRefunded: false };
  }
  state.refundIssued = true;
  try {
    await this.gemsService.refundSpend(state.wallet.gemTransactionId);
    return { gemRefunded: true };
  } catch (error) {
    return { gemRefunded: false, error };
  }
}
refundSpend 자체도 멱등이라 두 번 불려도 한 번만 되돌리지만, 턴 안에서는 한 번만 부르도록 호출 전에 따로 잠근다. 부분 실패한 환불을 뒤에서 재시도하면 이중 환불이 되기 때문이다. 실패 경로는 error 다음 done 순서로 스트림을 닫는다.
입력 판정이 턴을 되돌리는 경우(REVERT)도 같은 함수로 환불하고 error 다음 done으로 닫는다. 이때 AI 응답은 저장하지 않고, 사용자 발화는 지우지 않은 채 표시만 달아 이후 세션 맥락에서 빠지게 한다. 반대로 정형문으로 대답을 대신하는 판정(자해 신호에 지원 메시지로 답하는 경우 등)은 턴이 성립한 것이라 환불하지 않는다.
프론트엔드: ReadableStream 파싱
네이티브 EventSource를 쓰지 않으니 fetch 응답의 ReadableStream을 직접 파싱한다. event: 줄과 data: 줄을 갈라 이벤트 타입별 콜백을 돌리는 구조다.
// frontend/src/lib/sse.ts: sendMessageSSE 내부
buffer += decoder.decode(value, { stream: true });
const lines = buffer.split('\n');
buffer = lines.pop() || '';

let currentEvent = 'message';
for (const line of lines) {
  if (line.startsWith('event: ')) {
    currentEvent = line.slice(7).trim();
  } else if (line.startsWith('data: ')) {
    try {
      onEvent(currentEvent, JSON.parse(line.slice(6)));
    } catch {
      // 형식이 잘못된 데이터 건너뜀
    }
  }
}
마지막 줄은 아직 덜 온 줄일 수 있어서 버퍼에 남겨 두고 다음 청크와 이어 붙인다.
정리
- 파이프라인을 단계별로 분리하라. 나눠 두면 단계마다 따로 모델을 바꾸거나 최적화할 수 있고, 제품이 바뀌어 필요 없어진 단계(Target Resolution)를 통째로 걷어낼 수도 있다.
- 기다릴 필요 없는 일은 promise 로 띄워라. 입력 안전 심사를 생성과 병렬로 돌리고, 개입이 필요할 때만 생성을 끊는다. 생성이 먼저 끝난 턴을 위해 판정은 마지막에 한 번 더 확인한다.
- 스트리밍 JSON 파싱은 상태 머신이다. 중괄호 깊이 추적, 문자열 컨텍스트 인식, 이스케이프 처리. 이 셋 중 하나만 빠져도 파싱이 깨진다.
- POST-based SSE는 EventSource의 실용적 대안이다. GET 제약을 비껴가면서도 SSE의 이점(이벤트 타입 구분, 점진적 전송)은 그대로 남는다.
- 모델 이름이 아니라 용도를 넘겨라. 어느 모델을 쓸지는 DB 배정이 정하고, 폴백도 그 배정에 둔다. 모델 교체가 배포를 거치지 않는다.
- 첫 글자가 나간 뒤에는 바꾸지 마라. 재시도도 모델 폴백도 화면에 아무것도 나가지 않았을 때만 한다. 그 뒤에 다시 만든 응답은 앞 대사와 이어지지 않는다.
- 환불 기준은 화면에 도달한 양이다. 젬을 먼저 차감하고, 한 항목도 닿지 않은 완전 실패만 그 거래 하나를 되돌린다. 환불은 턴당 한 번으로 잠근다.