2026-10 개정: 지금의 Plit 에 맞춰 다시 썼다. 키워드 블랙리스트는 더 이상 스스로 막지 않고 LLM 심사기의 판정을 기다리게만 하며, 매칭에 어절 경계 검사가 붙었고, 캐시는 Redis 에서 프로세스 메모리로 옮겼다.
왜 콘텐츠 안전 필터링이 필요한가
AI 채팅 플랫폼에서 콘텐츠 안전은 나중에 얹는 기능이 아니다. 사용자가 아무 텍스트나 입력하고 AI도 아무 텍스트나 생성하는 구조라면, 부적절한 콘텐츠는 양쪽 어디서든 나온다.
영어라면 일이 비교적 단순하다. 단어 단위로 매칭해도 대부분 걸린다. 한국어는 사정이 전혀 다르다.
한국어에서 "섹스" 한 단어를 잡으려면 "섹 스", "ㅅㅔㄱㅅㅡ", "섹 스"(전각 공백), "sㅔㄱ스" 같은 변형을 전부 염두에 둬야 한다.
자모를 분리하거나 글자 사이에 공백을 끼우거나 유니코드 정규화 형태를 바꾸는 식으로, 한국어는 우회 경로가 여럿 열려 있다. 반대 방향의 문제도 있다. 공백을 지우고 비교하면 멀쩡한 문장이 금지어처럼 보인다. Plit에서는 정규화 파이프라인으로 변형을 한 형태로 모으고, 그 결과를 문맥을 읽는 LLM 심사기와 두 겹으로 묶었다. 그 과정을 적어 둔다.
한국어 텍스트 정규화 파이프라인
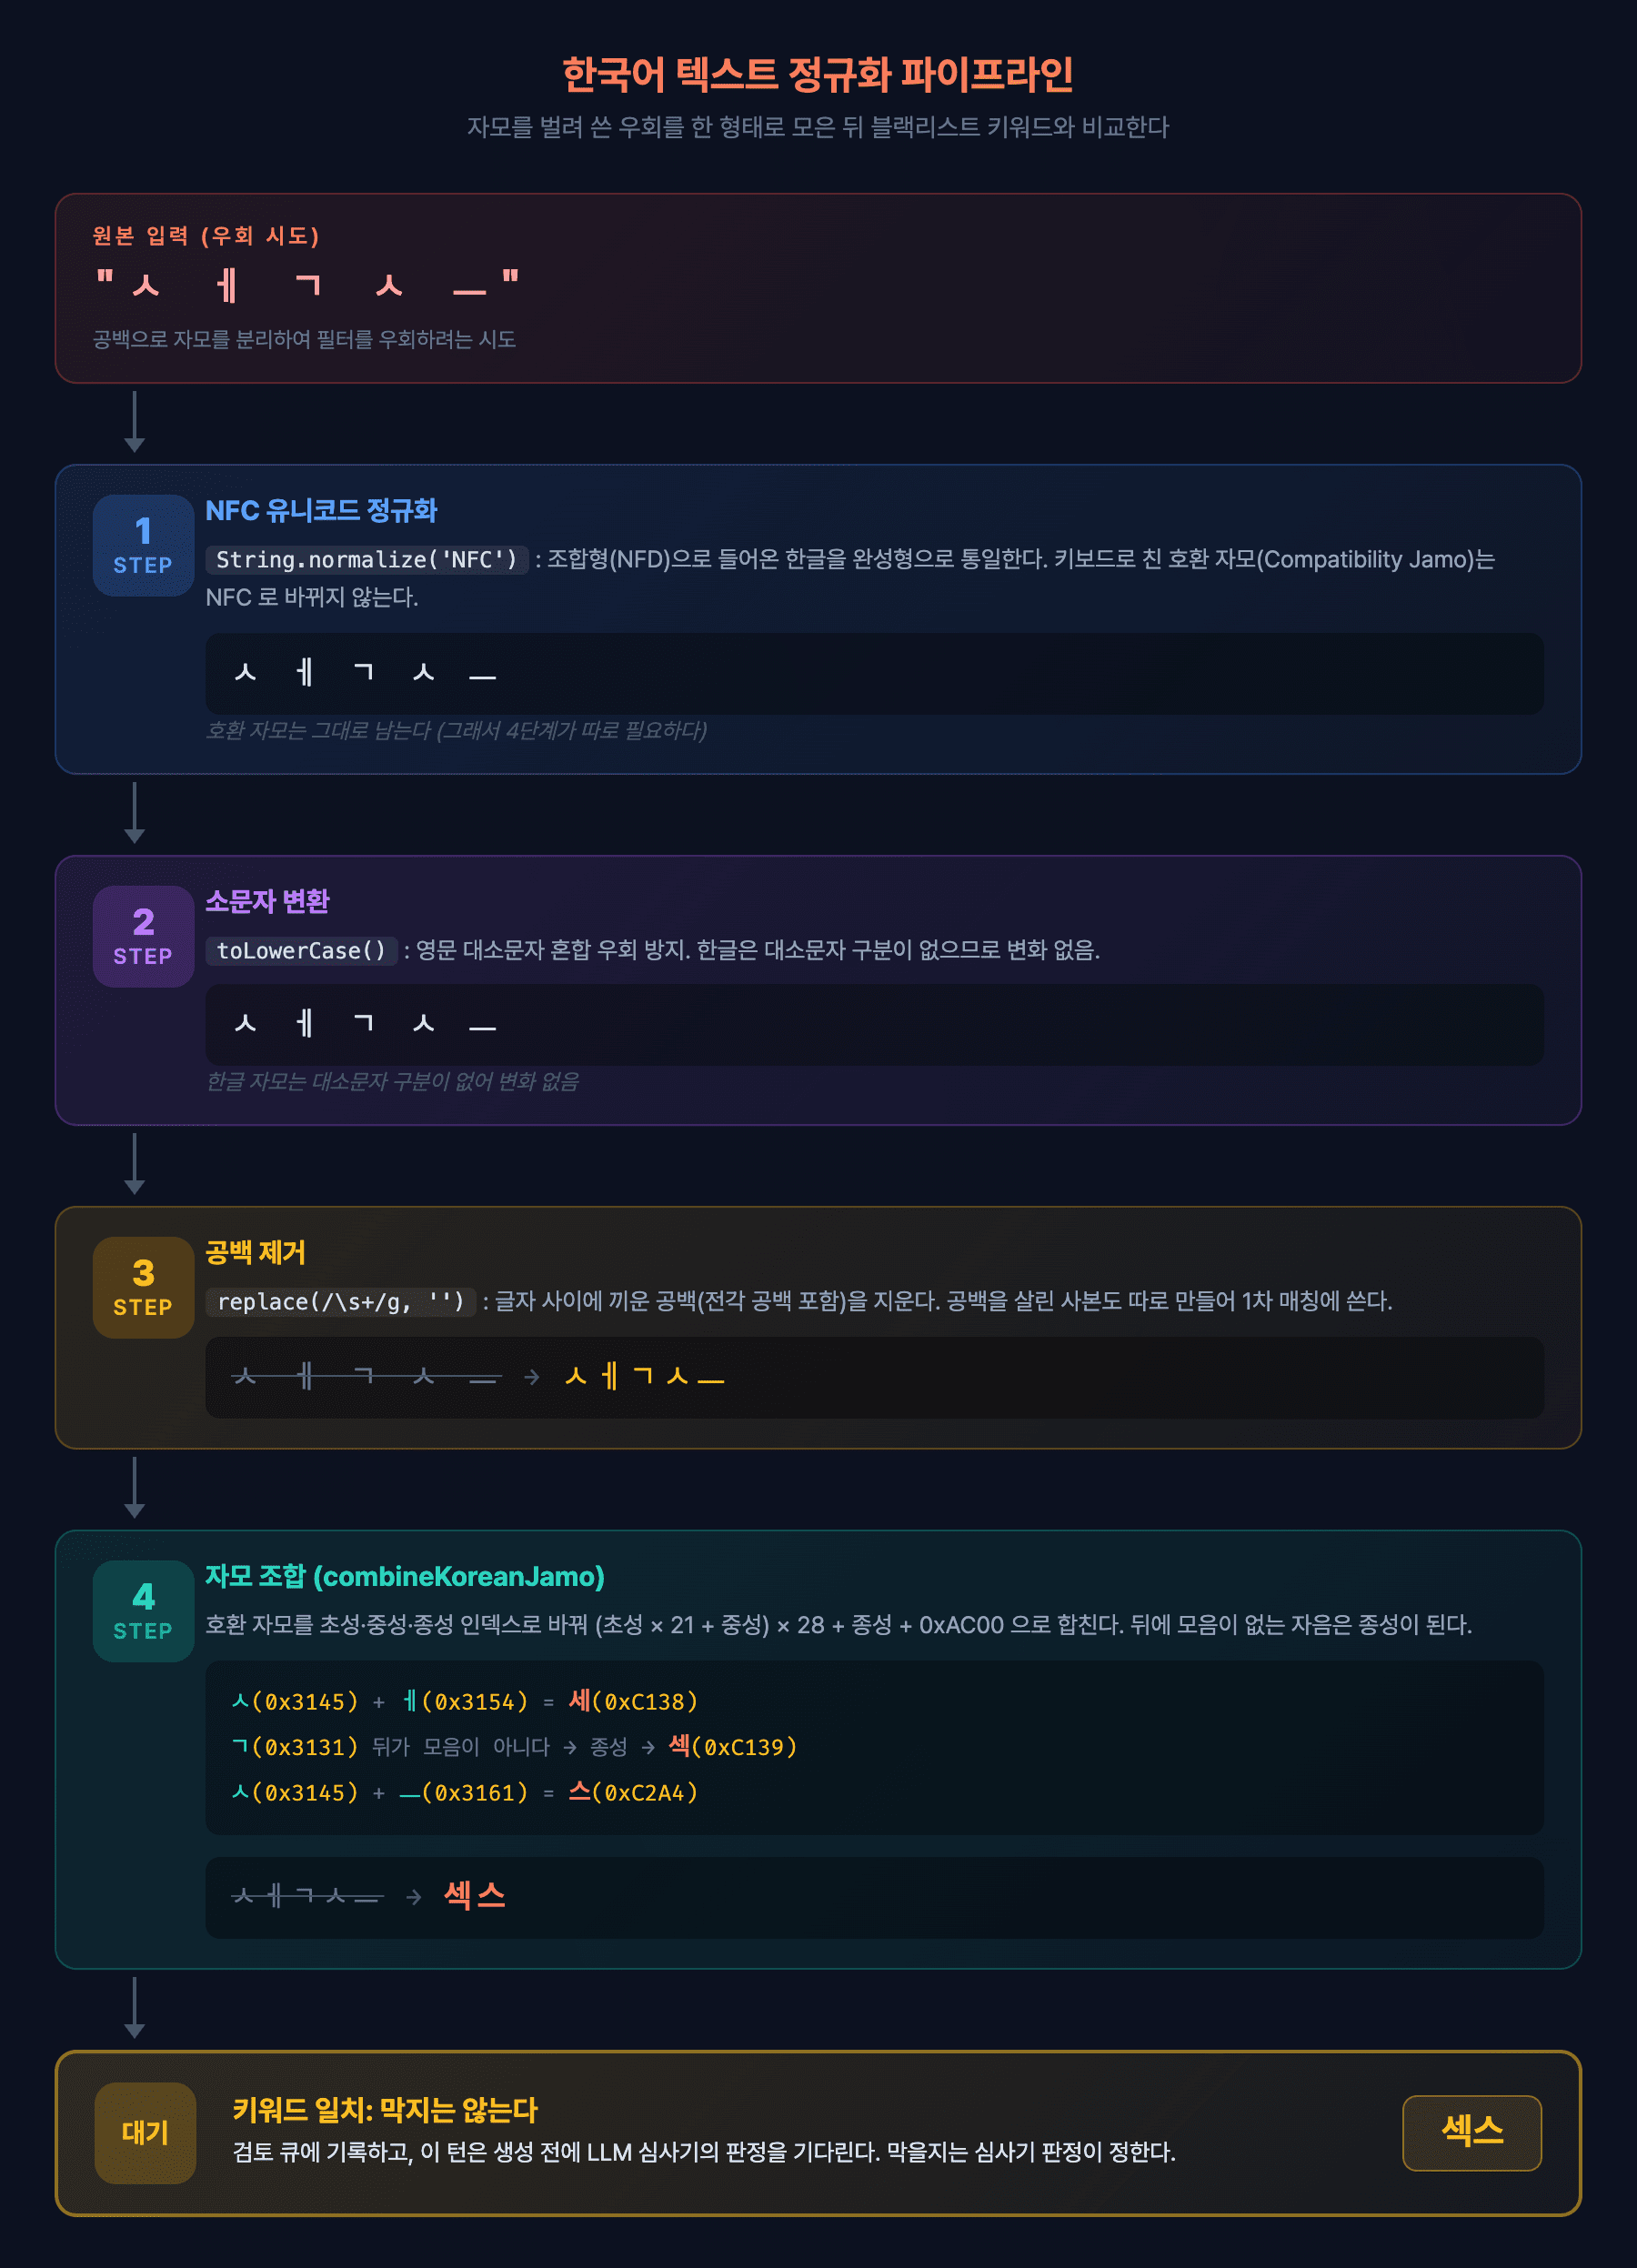
필터링의 출발점은 비교할 두 문자열을 같은 형태로 정규화하는 데 있다. 사용자 입력과 블랙리스트 키워드를 같은 파이프라인에 넣으면, 어떤 변형을 쓰든 결국 같은 문자열로 모인다.
// backend/src/content-safety/content-safety.service.ts
private normalizeText(text: string): string {
  let normalized = text.normalize('NFC');
  normalized = normalized.toLowerCase();
  // Remove spaces (prevents "아 동" bypass)
  normalized = normalized.replace(/\s+/g, '');
  return this.combineKoreanJamo(normalized).text;
}
단계마다 이유가 있다.
1단계, Unicode NFC 정규화. 유니코드는 같은 한글 글자를 여러 방식으로 표현한다. NFD(Normalization Form Decomposed)는 "가"를 초성과 중성 조합형으로 저장하고, NFC(Normalization Form Composed)는 완성형 한 글자로 저장한다. 브라우저와 OS, 입력기 중 무엇을 거쳐 오느냐에 따라 형태가 달라지니 NFC로 먼저 통일한다. 다만 키보드로 하나씩 친 호환 자모("ㅅ", "ㅔ")는 NFC 로 바뀌지 않는다. 4단계가 따로 있는 이유다.
2단계, 소문자 변환. 한국어 자체에는 대소문자가 없지만, "SEX"와 "sex"처럼 영문을 섞은 우회가 있어 필요하다.
3단계, 공백 제거. 가장 흔한 수법이다. "금 지 어"처럼 글자 사이를 벌려 놓으면 단순 문자열 매칭은 그대로 빗나간다. \s 는 전각 공백까지 잡으므로 "섹 스" 도 여기서 붙는다.
4단계, 자모 조합. 한국어에만 있는 우회 방식이라 아래 절에서 따로 다룬다.
공백을 지우지 않는 사본도 하나 더 만든다(normalizeTextKeepSpaces(), 1·2·4단계만 건다). 왜 두 벌이 필요한지는 바로 다음 절에서 나온다.
공백을 지우면 생기는 오탐: 어절 경계 검사
정규화만으로 비교하면 우회는 잡지만 오탐이 쏟아진다. "탁자 위에 올려둔 컵"에서 공백을 지우면 "탁자위에올려둔컵"이 되고, 그 안에 "자위"가 들어 있다. 공백을 지우는 순간 원래 문장에 없던 단어가 생겨난다. 공백과 무관한 오탐도 있다. "쳐다보지도 못한 채"는 낱말 하나 안에 다른 금지어를 품고 있다.
그래서 checkText()는 비교를 두 단계로 나누고, 매치가 나올 때마다 키워드 바로 앞 글자를 본다.
// backend/src/content-safety/content-safety.service.ts (발췌)
checkText(text: string, blacklist: BlacklistEntry[]): SafetyCheckResult {
  const tracked = this.normalizeTracked(text);
  const normalized = tracked.text;
  const normalizedKeepSpaces = this.normalizeTextKeepSpaces(text);
  // ...
  for (const entry of blacklist) {
    if (entry.matchType === 'REGEX') {
      // ...
    } else {
      const keywordKeepSpaces = this.normalizeTextKeepSpaces(entry.keyword);
      const normalizedKeyword = this.normalizeText(entry.keyword);

      // Phase 1: Check with spaces preserved
      if (this.hasWordBoundaryMatch(normalizedKeepSpaces, keywordKeepSpaces)) {
        matches.push({ keyword: entry.keyword, category: entry.category });
        continue;
      }

      // Phase 2: Check space-removed text (catches bypass like "자 위" → "자위")
      const isMultiToken = keywordKeepSpaces !== normalizedKeyword;
      const matchedPhase2 = isMultiToken
        ? normalized.includes(normalizedKeyword)
        : this.hasWordBoundaryMatch(normalized, normalizedKeyword, isSpacedBypass);
      if (matchedPhase2) {
        matches.push({ keyword: entry.keyword, category: entry.category });
      }
    }
  }
  return { flagged: matches.length > 0, matches };
}
hasWordBoundaryMatch()의 규칙은 한 줄이다. 키워드 바로 앞 글자가 한글 완성형 음절(0xAC00~0xD7AF)이면 복합어의 일부로 보고 건너뛴다. "쳐다보지도"는 금지어 앞에 "다"가 붙어 있으니 건너뛰고, 키워드 앞이 공백이거나 문장 처음이면 잡는다.
이 규칙만으로는 진짜 공백 우회까지 건너뛴다. "자 위를 했다"를 공백 없이 보면 "자위" 앞에 아무것도 없지만, 문장 중간의 "나 자 위를"이라면 앞에 한글이 붙는다. 그래서 2단계에는 isSpacedBypass가 따라간다. 공백을 지운 문자열의 각 글자가 원본의 몇 번째 글자였는지(normalizeTracked()가 만드는 startIndex)를 되짚어, 두 조건을 다 만족하면 우회로 판정한다.
- 매치 안쪽에서 공백이 지워졌다. 복합어에는 공백이 없다.
- 매치가 원본에서도 어절 시작이다. "탁자 위에"는 "자"가 원본에서 "탁" 뒤에 붙어 있으니 어절 시작이 아니다.
테스트가 양쪽을 다 못 박아 둔다.
// backend/src/content-safety/content-safety.service.spec.ts
it('should not flag a keyword straddling two real words (탁자 위에)', () => {
  const result = service.checkText('탁자 위에 올려둔 컵', [entry('자위')]);
  expect(result.flagged).toBe(false);
});
// backend/src/content-safety/content-safety.service.spec.ts
it('should detect space-bypass "자 위" → "자위"', () => {
  // ...
  const result = service.checkText('자 위를 했다', blacklist);
  // ...
});
경계를 키워드 앞에만 두는 데도 이유가 있다. 한국어는 조사가 키워드 뒤에 바로 붙는다. 뒤 경계까지 요구하면 "자살 방법을" 같은 진짜 위험 문장이 조사 하나 때문에 빠져나간다. 대신 앞 경계만 보면 짧은 키워드가 그것으로 시작하는 전혀 다른 단어를 잡는다. 실제로 두 글자 키워드가 이름·외래어와 부딪혔고, 그래서 CRITICAL 카테고리 키워드는 공백을 뺀 3글자 이상이어야 등록된다(CRITICAL_KEYWORD_MIN_LENGTH = 3, backend/src/admin/constants/blacklist-keyword-guard.constants.ts). 경계를 정확히 표현해야 하는 경우는 REGEX 매치 타입으로 등록한다.
남는 구멍도 있다. "sㅔㄱ스"처럼 라틴 문자를 섞은 변형은 이 정규화로 모이지 않는다. 정규화가 하는 일은 같은 글자의 다른 표기를 하나로 모으는 데까지다.
ㅇㅏㄷㅗㅇ은 어떻게 "아동"이 되는가
먼저 한글 음절이 유니코드에서 어떻게 생겼는지 봐야 한다. 완성형 한글 한 글자는 초성 + 중성 + (종성) 이고, 코드포인트는 다음 공식을 따른다.
코드포인트 = (초성 × 21 + 중성) × 28 + 종성 + 0xAC00
"동"을 만들어 보자. 초성 ㄷ(인덱스 3) × 21 + 중성 ㅗ(인덱스 8) = 71, 71 × 28 + 종성 ㅇ(인덱스 21) = 2009, 2009 + 0xAC00 = 0xB3D9. 이 값이 "동"의 유니코드 코드포인트다.
자모 조합을 구현하려면 호환 자모(0x3131~0x3163 범위)를 초성·중성·종성 인덱스로 바꿔 줄 매핑 테이블부터 있어야 한다.
// backend/src/content-safety/content-safety.service.ts (발췌)
// Choseong: ㄱㄲㄴㄷㄸㄹㅁㅂㅃㅅㅆㅇㅈㅉㅊㅋㅌㅍㅎ
const CHOSEONG_MAP: Record<number, number> = {
  0x3131: 0, // ㄱ
  0x3132: 1, // ㄲ
  0x3134: 2, // ㄴ
  0x3137: 3, // ㄷ
  // ... 19개
  0x314e: 18, // ㅎ
};

// Jungseong: ㅏㅐㅑㅒㅓㅔㅕㅖㅗㅘㅙㅚㅛㅜㅝㅞㅟㅠㅡㅢㅣ
const JUNGSEONG_MAP: Record<number, number> = {
  0x314f: 0, // ㅏ
  0x3150: 1, // ㅐ
  0x3151: 2, // ㅑ
  // ... 21개
  0x3163: 20, // ㅣ
};

// Jongseong mapping (consonant code -> jongseong index)
const JONGSEONG_MAP: Record<number, number> = {
  0x3131: 1, // ㄱ
  0x3132: 2, // ㄲ
  0x3134: 4, // ㄴ
  // ... 16개
  0x314e: 27, // ㅎ
};
여기서 갈리는 지점은 호환 자모(Compatibility Jamo, 0x31310x3163)와 조합용 자모(Conjoining Jamo, 0x11000x11FF)가 서로 다른 블록이라는 사실이다. 사용자가 키보드로 자모를 하나씩 치면 호환 자모 쪽 코드포인트가 나오고, 앞에서 말했듯 NFC 는 이걸 건드리지 않는다. 그러니 직접 초성과 중성과 종성으로 나눠 완성형 글자로 합쳐야 한다.
조합 알고리즘의 뼈대는 이렇다. 지금 구현은 합친 글자마다 그것이 입력의 몇 번째 글자에서 시작했는지(startIndex)도 함께 돌려준다. 앞 절의 공백 우회 판정이 이 값으로 원본을 되짚는다.
// backend/src/content-safety/content-safety.service.ts (발췌)
private combineKoreanJamo(text: string): { text: string; startIndex: number[] } {
  const result: string[] = [];
  const startIndex: number[] = [];
  let i = 0;

  while (i < text.length) {
    const start = i;
    const code = text.charCodeAt(i);

    // Check if current char is a choseong consonant
    if (this.isChoseong(code) && i + 1 < text.length) {
      const nextCode = text.charCodeAt(i + 1);

      // Check if next char is a jungseong vowel
      if (this.isJungseong(nextCode)) {
        const cho = CHOSEONG_MAP[code];
        const jung = JUNGSEONG_MAP[nextCode];
        let jong = 0;

        // Check for trailing consonant (jongseong)
        if (i + 2 < text.length) {
          const thirdCode = text.charCodeAt(i + 2);

          if (this.isChoseong(thirdCode)) {
            // Only use as jongseong if NOT followed by a vowel
            if (i + 3 >= text.length || !this.isJungseong(text.charCodeAt(i + 3))) {
              if (JONGSEONG_MAP[thirdCode] !== undefined) {
                jong = JONGSEONG_MAP[thirdCode];
                i += 3;
                result.push(String.fromCharCode((cho * 21 + jung) * 28 + jong + 0xac00));
                startIndex.push(start);
                continue;
              }
            }
          }
        }

        // Combine without jongseong
        result.push(String.fromCharCode((cho * 21 + jung) * 28 + jong + 0xac00));
        startIndex.push(start);
        i += 2;
        continue;
      }
    }

    result.push(text[i]);
    startIndex.push(start);
    i++;
  }

  return { text: result.join(''), startIndex };
}
이 알고리즘에서 제일 까다로운 대목은 종성과 초성의 경계 판단이다. "ㅇㅏㄷㅗㅇ"을 처리할 때, 세 번째 문자 "ㄷ"은 "아"의 종성이 아니라 "동"의 초성이다. 판정 규칙 자체는 단순하다: 뒤에 모음이 오면 다음 글자의 초성이고, 아니면 현재 글자의 종성이다. "ㄷ" 뒤에 "ㅗ"(모음)가 붙으니 "ㄷ"은 다음 글자의 초성으로 간다.
테스트 코드가 이 동작을 못 박아 둔다.
// backend/src/content-safety/content-safety.service.spec.ts
it('should detect sexual keywords in jamo form (bypass attempt)', () => {
  const result = service.checkText('ㅅㅔㄱㅅㅡ', sexualKeywords);
  expect(result.flagged).toBe(true);
});
키워드는 판정하지 않는다: 두 겹의 안전 판정
AI 채팅에서 검사할 지점은 두 곳이다. 사용자 입력(AI가 처리하기 전), 그리고 AI 출력(사용자에게 닿기 전). Plit의 대화는 POST-based SSE 스트리밍으로 흐르기 때문에, 출력 쪽은 스트리밍 도중에 검사해야 한다.
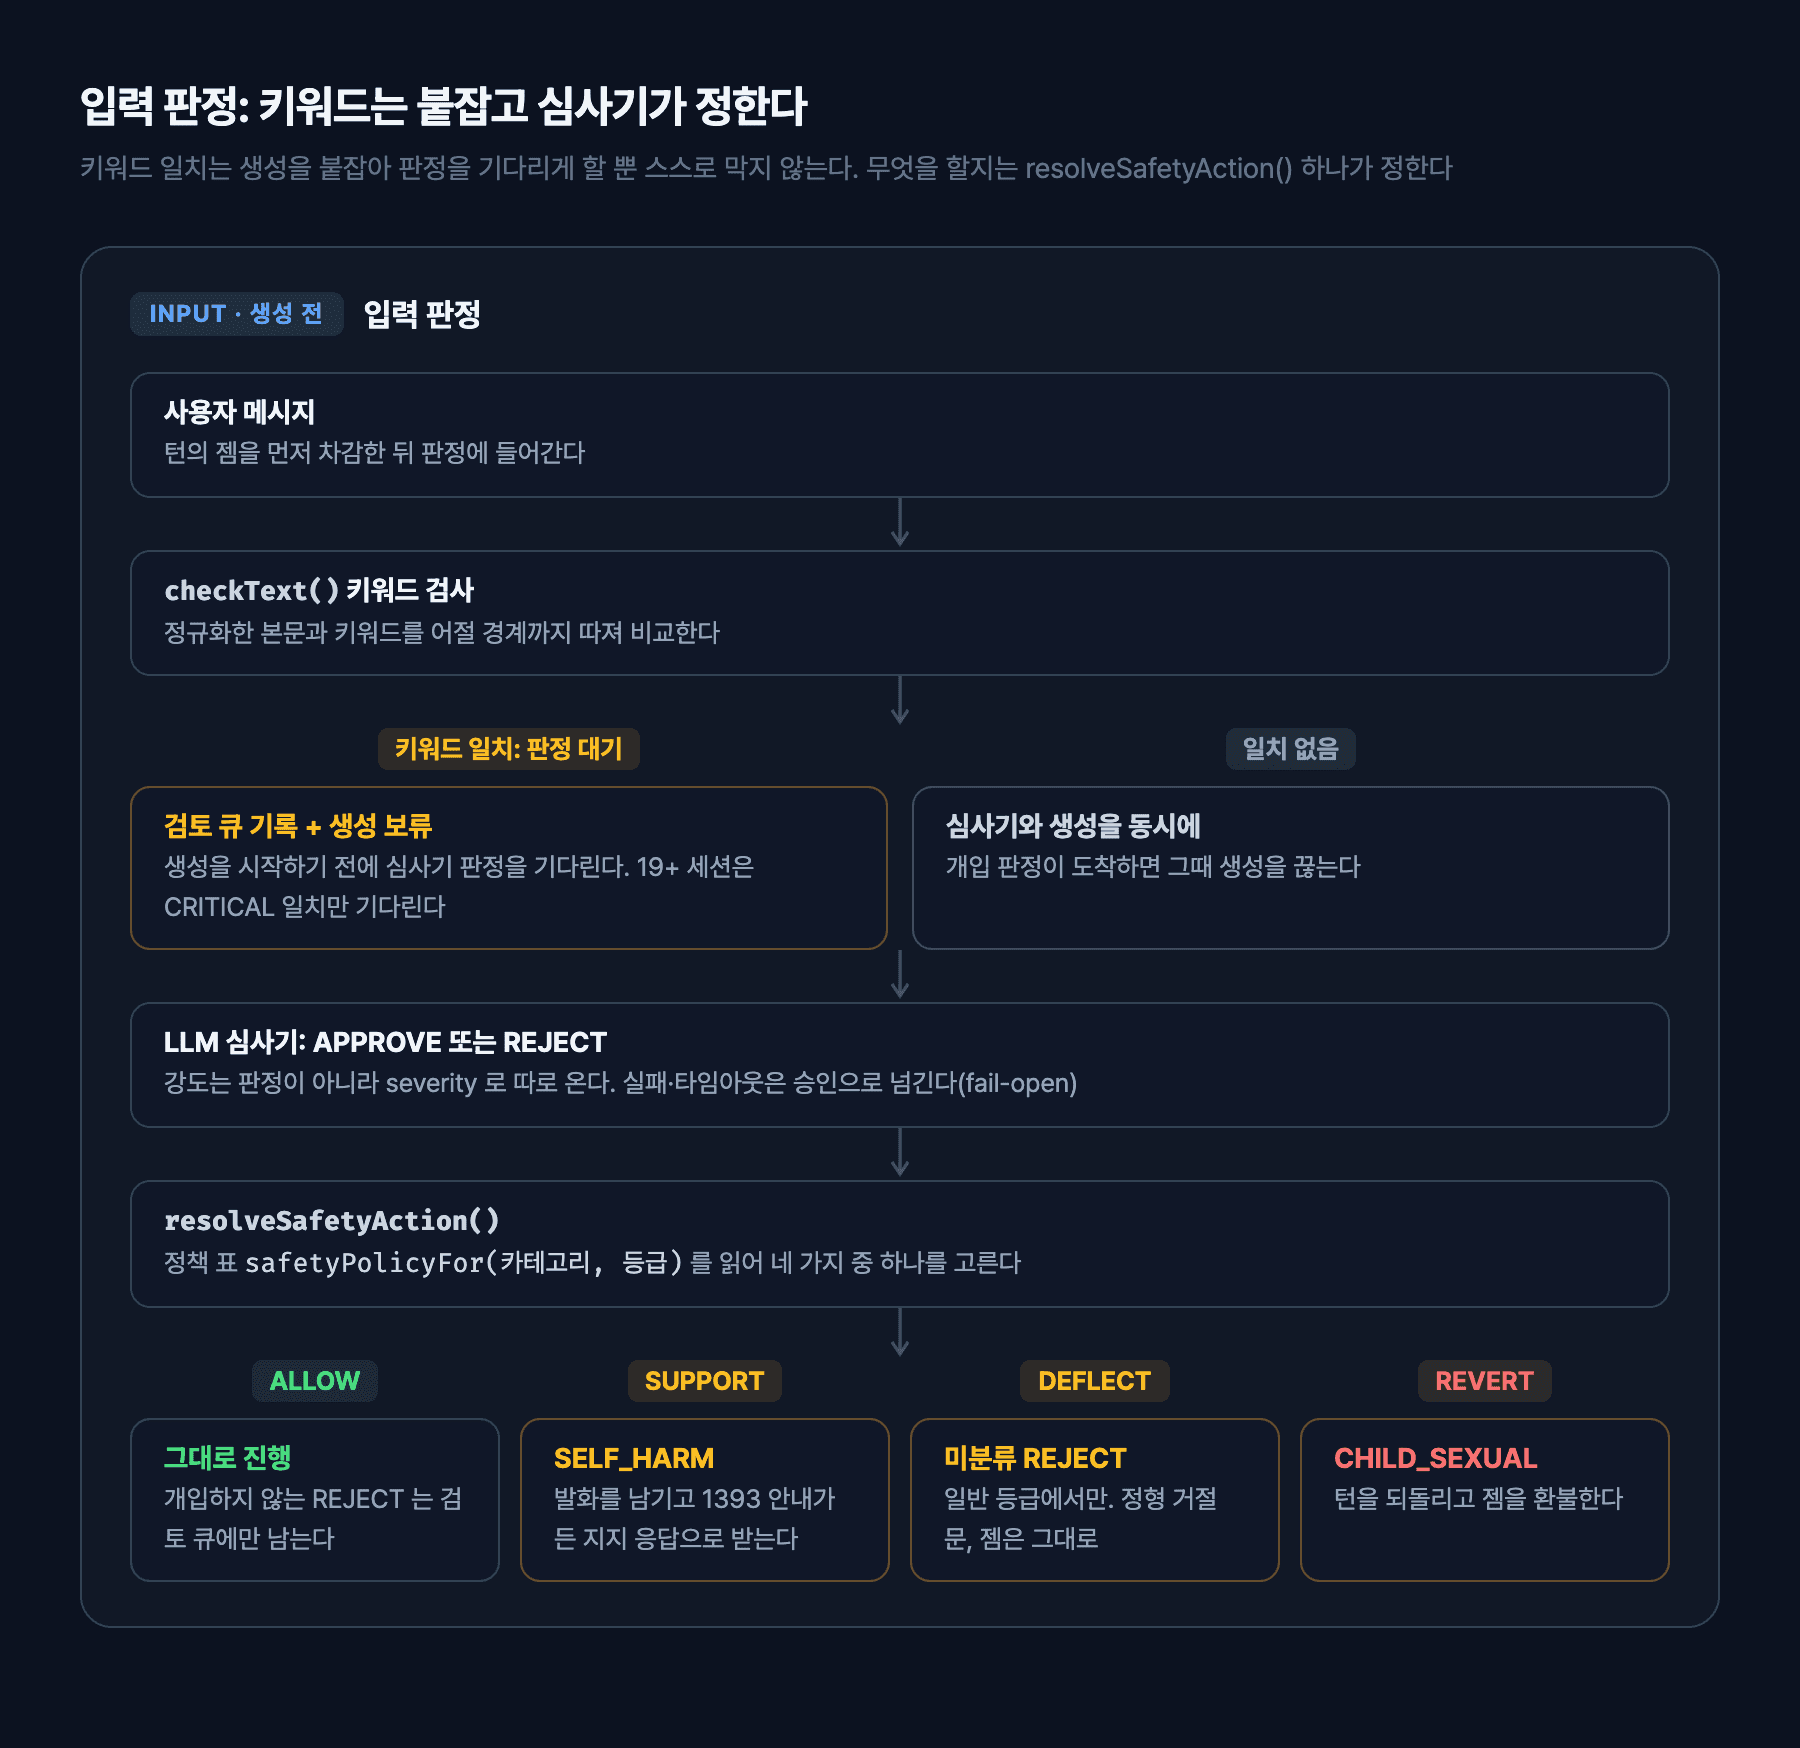
초기에는 키워드가 일치하면 곧바로 턴을 끊고 젬을 돌려줬다. 그런데 키워드는 문맥을 못 본다. 인용인지, 부정문인지, 그냥 이름인지 구분하지 못한다. 앞 절의 경계 검사로 오탐을 줄여도 "그런 말 하지 마"와 그 말을 하는 문장은 키워드 입장에서 똑같다. 그래서 지금은 키워드 일치가 스스로 아무것도 막지 않는다. 판정은 문맥을 읽는 LLM 심사기가 하고, 키워드는 "이 턴은 판정을 먼저 받고 가라"는 신호만 남긴다.
입력: 키워드는 생성을 붙잡고, 심사기가 정한다
// backend/src/chat/chat-turn.service.ts (발췌)
const blacklist = await this.contentSafety.loadBlacklist();
const inputCheck = this.contentSafety.checkText(content, blacklist);
const inputCriticalMatch = inputCheck.matches.find((m) =>
  isCriticalCategory(m.category),
);
// ... 일치한 키워드는 검토 큐에 action: 'warned' 로 남긴다

// 19+ 세션은 CRITICAL(아동·자해) 적중만 붙잡는다. 성적 키워드로 매 턴 묶이면 19+ 를 여는 의미가 없다
const holdForKeyword =
  pipelineContext.ageRating === AgeRating.NINETEEN_PLUS
    ? Boolean(inputCriticalMatch)
    : inputCheck.flagged;
pipelineContext.awaitInputSafety = holdForKeyword;
pipelineContext.keywordFallbackCategory = inputCriticalMatch?.category;
입력 심사기는 모든 턴에 돈다. 차이는 순서다. 키워드가 잡지 않은 턴은 심사와 응답 생성을 동시에 시작하고, 개입 판정이 도착하면 그때 생성을 끊는다(AbortController). 키워드가 잡은 턴(awaitInputSafety)만 생성을 시작하기 전에 판정을 기다린다. 첫 글자까지의 지연이 늘어나는 것은 이 드문 턴뿐이다.
심사기의 판정은 APPROVE 아니면 REJECT 둘뿐이다. 얼마나 센지는 판정이 아니라 severity(CRITICAL/HIGH/MEDIUM)로 따로 온다. 심사 모델 이름은 코드에 없고, 호출부는 용도(LlmTask.CONTENT_SAFETY)만 넘긴다. 어느 모델이 그 용도를 맡을지는 llm_task_assignments 테이블이 정한다.
판정이 나온 뒤 무엇을 할지는 함수 하나가 정한다.
// backend/src/ai-pipeline/safety-policy.ts
export function resolveSafetyAction(v: SafetyVerdictInput): SafetyAction {
  if (v.decision !== 'REJECT') return 'ALLOW';
  const { intervene } = safetyPolicyFor(
    v.category,
    v.ageRating ?? AgeRating.ALL,
  );
  return intervene === 'NONE' ? 'ALLOW' : intervene;
}
이 함수에는 규칙이 없다. 카테고리와 세션 등급(일반 ALL / 19+)으로 정책 표 safetyPolicyFor()(packages/shared/src/safety-policy-table.ts)를 읽을 뿐이다. 입력 단계와 출력 단계가 이 함수를 같이 부르므로 두 관문의 규칙이 갈라질 수 없다. 결과는 네 가지다.
| 행동 | 언제 | 무엇을 하나 |
|---|---|---|
ALLOW | 표가 개입을 정하지 않은 REJECT 전부 | 그대로 진행한다. 표가 기록하는 축이면 검토 큐에만 남는다 |
SUPPORT | SELF_HARM | 막지 않는다. 발화는 화면에 남고, 캐릭터가 자살예방상담전화 1393 안내가 든 정형 지지 응답을 말한다 |
DEFLECT | 카테고리를 모르는 REJECT, 일반 등급에서만 | 생성물을 버리고 정형 거절문으로 바꾼다. 턴은 성립하고 젬은 돌려주지 않는다 |
REVERT | CHILD_SEXUAL | 턴을 되돌린다. AI 응답은 저장하지 않고 젬을 환불한다 |
SEXUAL_EXPLICIT와 VIOLENCE_GORE는 두 등급 모두 판정도 기록도 하지 않는다. 등급 안에서 캐릭터가 생성 프롬프트로 받아넘길 창작 롤플레이라는 판단이다. 거절문과 지지 응답은 모델이 쓰지 않는다(SAFETY_DEFLECTION_TEXT, SELF_HARM_SUPPORT_TEXT, packages/shared/src/content-safety.ts). 모델이 거절문을 지어내게 두면 그 문장이 다음 우회의 재료가 된다.
젬은 입력 판정 전에 이미 빠져 있다. 그래서 되돌림 경로만 환불을 부른다.
// backend/src/chat/chat-turn.service.ts (발췌): 되돌림 경로
markTurnBlocked(BLOCKED_REASONS.INPUT_FILTER);
await this.chatService
  .markMessageSafetyRejected(savedMsg.id)
  .catch((err) => this.logger.warn('Failed to mark rejected message', err));

const { gemRefunded, error: refundError } =
  await this.issueRefundOnce(state);
if (refundError) {
  this.logger.error('Safety refund failed:', refundError);
}

endBlocked(sink, {
  message: SAFETY_BLOCK_MESSAGE,
  code: SSE_ERROR_CODES.INPUT_FILTER_BLOCKED,
  category: verdictCategory,
  gemRefunded,
});
유저 발화는 지우지 않고 chat_messages.safety_rejected 표시만 달아 남긴다. 그 행은 메시지 목록, 프롬프트 히스토리, 기억 생성 같은 세션의 읽기 경로 어디에도 실리지 않는다. 환불을 맡는 gemsService.refundSpend()는 소비 거래 ID로 원래 로트를 되돌리는 방식이라 멱등하고, 같은 턴에서 여러 경로가 겹쳐도 issueRefundOnce()가 실제 호출을 한 번으로 묶는다.
심사기가 실패하거나 10초 안에 답하지 않으면 그 턴은 승인된다(fail-open). 심사기 장애가 서비스 장애가 되지 않게 하려는 선택이다. 이때 키워드가 다시 쓸모를 얻는다. 판정을 못 받은 턴에서 키워드가 CRITICAL 카테고리로 잡아 둔 것이 있으면(keywordFallbackCategory) 그 카테고리로 판정한 것처럼 처리한다. 이 후퇴선이 없으면 심사기 장애가 곧 키워드 레이어의 무력화가 된다. 반대로 심사 모델이 판정 자체를 거부한 경우만은 fail-close 다. 프로바이더 차단은 겉보기에 장애와 구분되지 않아서, 응답 본문을 읽어 따로 가려낸 뒤 승인 대신 REJECT 로 닫는다.
출력: CRITICAL 만 스트리밍 도중에 바꿔 끼운다
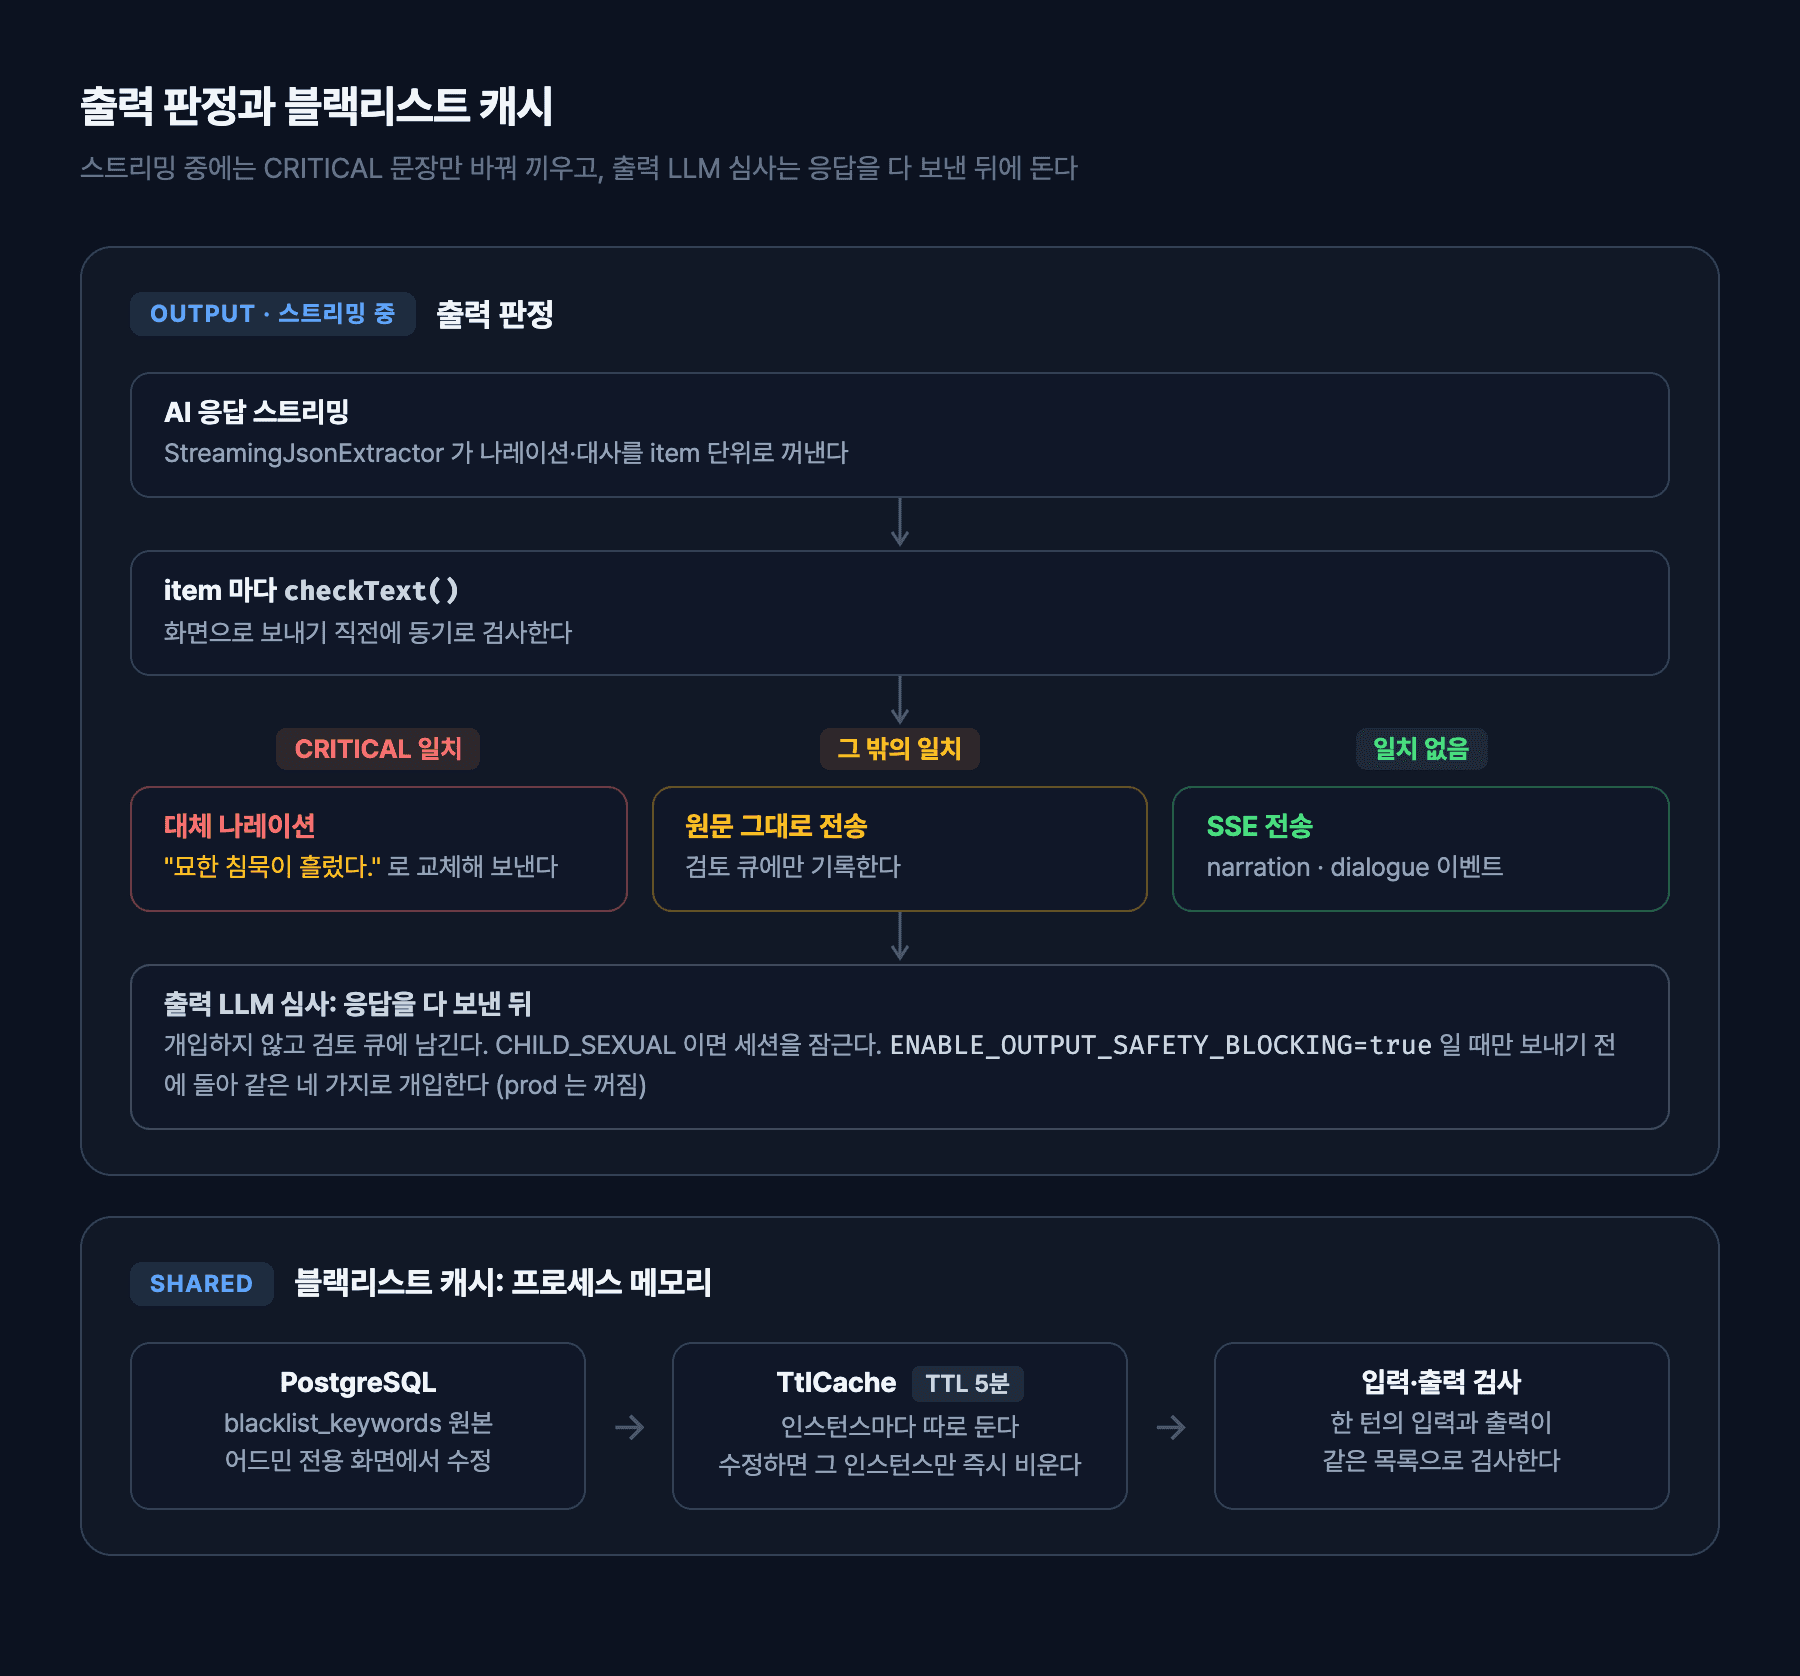
출력 쪽 키워드 검사는 AI가 만든 텍스트가 item 단위로 흘러나가는 도중에, 화면으로 보내기 직전에 동기로 돈다.
// backend/src/chat/chat-turn.service.ts (발췌): streamItem()
const outputCheck = this.contentSafety.checkText(textToCheck, prepared.blacklist);
const outputCriticalMatch = outputCheck.matches.find((m) =>
  isCriticalCategory(m.category),
);
if (outputCheck.flagged) {
  // ... 검토 큐 기록 (CRITICAL 이면 'replaced', 아니면 'warned')
  if (outputCriticalMatch) {
    send(sseFrame(SSE_EVENTS.NARRATION, { text: OUTPUT_REPLACEMENT_TEXT }));
    send(
      sseFrame(SSE_EVENTS.ERROR, {
        code: SSE_ERROR_CODES.OUTPUT_FILTER_BLOCKED,
        category: primaryCategory,
      }),
      false,
    );
    return;
  }
}
CRITICAL 카테고리(CHILD_SEXUAL, SELF_HARM)에 걸린 문장만 대체 나레이션 OUTPUT_REPLACEMENT_TEXT("묘한 침묵이 흘렀다.")로 바꿔 보낸다. 나머지 일치는 원문 그대로 내보내고 검토 큐에만 남긴다. 입력과 출력이 다른 전략을 쓰는 이유는 출력은 이미 흐르는 중이라는 데 있다. 입력은 생성을 미뤄 판정을 기다릴 수 있지만, 출력에서 문장마다 심사를 기다리면 스트리밍의 의미가 없어진다.
출력의 LLM 심사는 응답을 다 보낸 뒤에 돈다. 그래서 어떤 판정도 대화에 개입하지 않고 검토 큐에 남을 뿐이다. 예외가 하나 있다. 출력 판정이 CHILD_SEXUAL이면 그 세션을 잠근다(play_sessions.safety_locked_at). 다음 턴은 거부되고, 그 턴부터 만든 기억은 무효가 되며, 해제는 관리자만 한다. 계정이 아니라 세션 하나에 거는 잠금이다. 운영 스위치 ENABLE_OUTPUT_SAFETY_BLOCKING=true를 켜면 출력 심사를 보내기 전에 돌려 같은 네 가지 행동으로 개입하지만, 첫 글자 지연이 늘어나므로 prod 에서는 꺼 두었다.
캐싱과 감사 로그
블랙리스트는 프로세스 메모리에 둔다
블랙리스트는 매 턴 읽힌다. 처음에는 Redis 에 1시간 TTL 로 캐싱했는데, 그러면 요청마다 Redis 명령 한 번씩을 낸다. 지금은 NestJS 인스턴스마다 메모리에 5분짜리 캐시(TtlCache)를 따로 둔다. 한 턴 안에서는 입력 검사에 쓴 목록을 출력 검사가 그대로 이어받는다.
// backend/src/content-safety/content-safety.service.ts (발췌)
const BLACKLIST_MEMO_TTL_SEC = 300;

async loadBlacklist(): Promise<BlacklistEntry[]> {
  const memoHit = this.memo.get();
  if (memoHit) return memoHit;
  return this.reloadBlacklistFromDb();
}

private async reloadBlacklistFromDb(): Promise<BlacklistEntry[]> {
  // 배포 중 새 enum 값 행이 먼저 들어와도 이 빌드가 읽다 죽지 않게 아는 값만 읽는다
  const keywords = await this.prisma.blacklistKeyword.findMany({
    where: {
      isActive: true,
      category: { in: Object.values(SafetyCategory) },
      matchType: { in: Object.values(SafetyMatchType) },
    },
    select: { keyword: true, category: true, matchType: true },
  });
  // ...
}
대가도 있다. 어드민에서 블랙리스트를 고치면 refreshBlacklistCache()가 요청을 받은 인스턴스의 캐시만 비운다. 다른 인스턴스는 최대 TTL 5분만큼 늦게 새 목록을 본다. 그 5분 동안 늦는 것은 차단이 아니라 "판정을 먼저 받으라"는 신호다. 심사기는 그 사이에도 모든 턴을 본다.
감사 로그
키워드 일치와 심사기 판정은 content_safety_logs 테이블에 남고, 어드민 검토 큐(/admin/safety)에 PENDING으로 쌓인다.
// backend/prisma/schema.prisma (발췌)
model ContentSafetyLog {
  id              String            @id @default(uuid())
  sessionId       String?           @map("session_id")
  userId          String?           @map("user_id")
  messageId       String?           @map("message_id")
  /// 판정이 난 턴의 Langfuse trace id. Langfuse 미설정 환경에서는 null.
  traceId         String?           @map("trace_id")
  filterStage     String            @map("filter_stage")
  originalContent String            @map("original_content") @db.Text
  matchedKeywords String[]          @map("matched_keywords")
  category        SafetyCategory?
  severity        String?
  action          String
  status          SafetyAlertStatus @default(PENDING)
  // ... reviewedBy, reviewedAt, notes, createdAt, isTestSession

  @@map("content_safety_logs")
  @@schema("safety")
}
action에는 실제로 일어난 일이 들어간다. 되돌림은 blocked, 거절문 대체와 출력 치환은 replaced, 지지 응답은 supported, 개입하지 않은 기록은 warned다. traceId는 검토 큐에서 그 턴의 실행 트레이스로 돌아가는 유일한 단서다.
이 테이블은 플랫폼에서 가장 민감한 원문이 모이는 곳이다. 그래서 originalContent와 matchedKeywords는 평문으로 남기지 않고 대화 원문(chat_messages.content)과 같은 키로 암호화해 저장한다. 판정 사유가 원문을 그대로 서술하기 때문에 키워드 배열도 예외가 아니다.
카테고리는 SafetyCategory(packages/shared/src/enums.ts) 12종이고, 위험도는 CATEGORY_SEVERITY_MAP이 CRITICAL / HIGH / MEDIUM 셋 중 하나로 매긴다. 블랙리스트 키워드와 심사기가 같은 enum 을 쓰므로, 어떤 유형의 신호가 얼마나 나오는지 한 축으로 세어 볼 수 있다. 이 로그로 계정을 정지하는 자동 경로는 없다. 계정 제재는 관리자가 기간과 사유를 적어 직접 건다.
정리
- 한국어 필터링은 단순 문자열 매칭으로 안 된다. 자모 분리와 공백 삽입, 유니코드 정규화 차이까지 한국어에만 있는 우회 경로를 하나씩 모아야 한다.
- 정규화 파이프라인이 출발점이다. NFC → lowercase → 공백 제거 → 자모 조합을 지나면 변형 대부분이 한 형태로 모인다. 호환 자모는 NFC 가 건드리지 않으니 조합은 직접 해야 한다.
- 유니코드 한글 조합 공식
(초성 × 21 + 중성) × 28 + 종성 + 0xAC00은 외워 둘 만하다. 자모를 완성형 글자로 합치는 일이 이 한 줄로 끝난다. - 종성인지 초성인지는 한 글자 더 앞을 봐야 갈린다. 연속된 자모에서 자음 하나가 현재 글자의 종성인지 다음 글자의 초성인지는, 그 뒤에 모음이 붙었는지가 정한다.
- 공백을 지우면 없던 단어가 생긴다. 키워드 앞 글자가 한글 음절이면 복합어로 보고 건너뛰되, 원본으로 되짚어 공백으로 쪼갠 우회만 다시 잡는다. 경계를 앞에만 두는 것은 조사가 뒤에 붙는 한국어의 구조 때문이다.
- 키워드는 판정하지 않는다. 문맥을 못 보는 키워드는 생성을 붙잡아 심사기 판정을 기다리게만 하고, 무엇을 할지는
resolveSafetyAction()이 정책 표를 읽어 정한다. 막는 것은CHILD_SEXUAL되돌림뿐이고, 자해 신호는 막지 않고 지지 응답으로 받는다. - 입력과 출력은 전략이 달라야 한다. 입력은 생성을 미뤄 판정을 받을 수 있지만, 이미 흐르는 출력은 CRITICAL 문장만 그 자리에서 바꿔 끼우고 나머지 판정은 응답 뒤로 미룬다.
- 감사 로그는 필터링만큼 중요하고, 그만큼 민감하다. 무엇이 실제로 일어났는지(
action)와 그 턴의 트레이스를 남기되, 원문은 암호화해 둔다.