2026-10 개정: 이 글은 지금의 Plit 코드에 맞춰 다시 썼다. 기억 테이블이 세션 단위
session_memories에서 사용자×캐릭터 단위user_memories로 바뀌었고, 임베딩은 Gemini 768차원, 시간 감쇠는 SQL 밖의 시퀀스 감쇠, 젬 차감은 지갑 잠금 + 로트 원장으로 바뀌었으며, 직접 확인하지 않은 PostgreSQL 18 성능 주장은 걷어냈다.
도입
Plit은 AI 캐릭터와 1:1로 대화하는 캐릭터 챗 플랫폼이다. 백엔드 스택은 NestJS 11 + Prisma 7 + PostgreSQL 18 + pgvector다.
Prisma 7의 driver adapter는 엔진 바이너리 대신 Node.js pg 드라이버로 DB에 붙는다. NestJS 11의 DI 시스템은 AppModule 에 직접 등록된 60개가 넘는 모듈을 묶는다. pgvector는 별도 인프라 없이 PostgreSQL 안에서 시맨틱 검색을 돌린다. PostgreSQL 18은 로컬(pgvector/pgvector:pg18)과 프로덕션(Render PostgreSQL 18) 양쪽에서 쓴다.
물론 "최신"에는 대가가 따른다. ERD 제너레이터가 Prisma 7과 호환되지 않아 꺼 두었고, migrate dev는 pgvector 인덱스를 지우는 SQL을 매번 만들어 낸다. 벡터 타입은 Prisma가 이해하지 못해 raw SQL을 섞어 써야 한다. 이 글은 개발하면서 밟은 호환성 문제와 그 해결책을 정리한 것이다.
핵심 1: Prisma 7의 driver adapter와 생성 클라이언트 설정
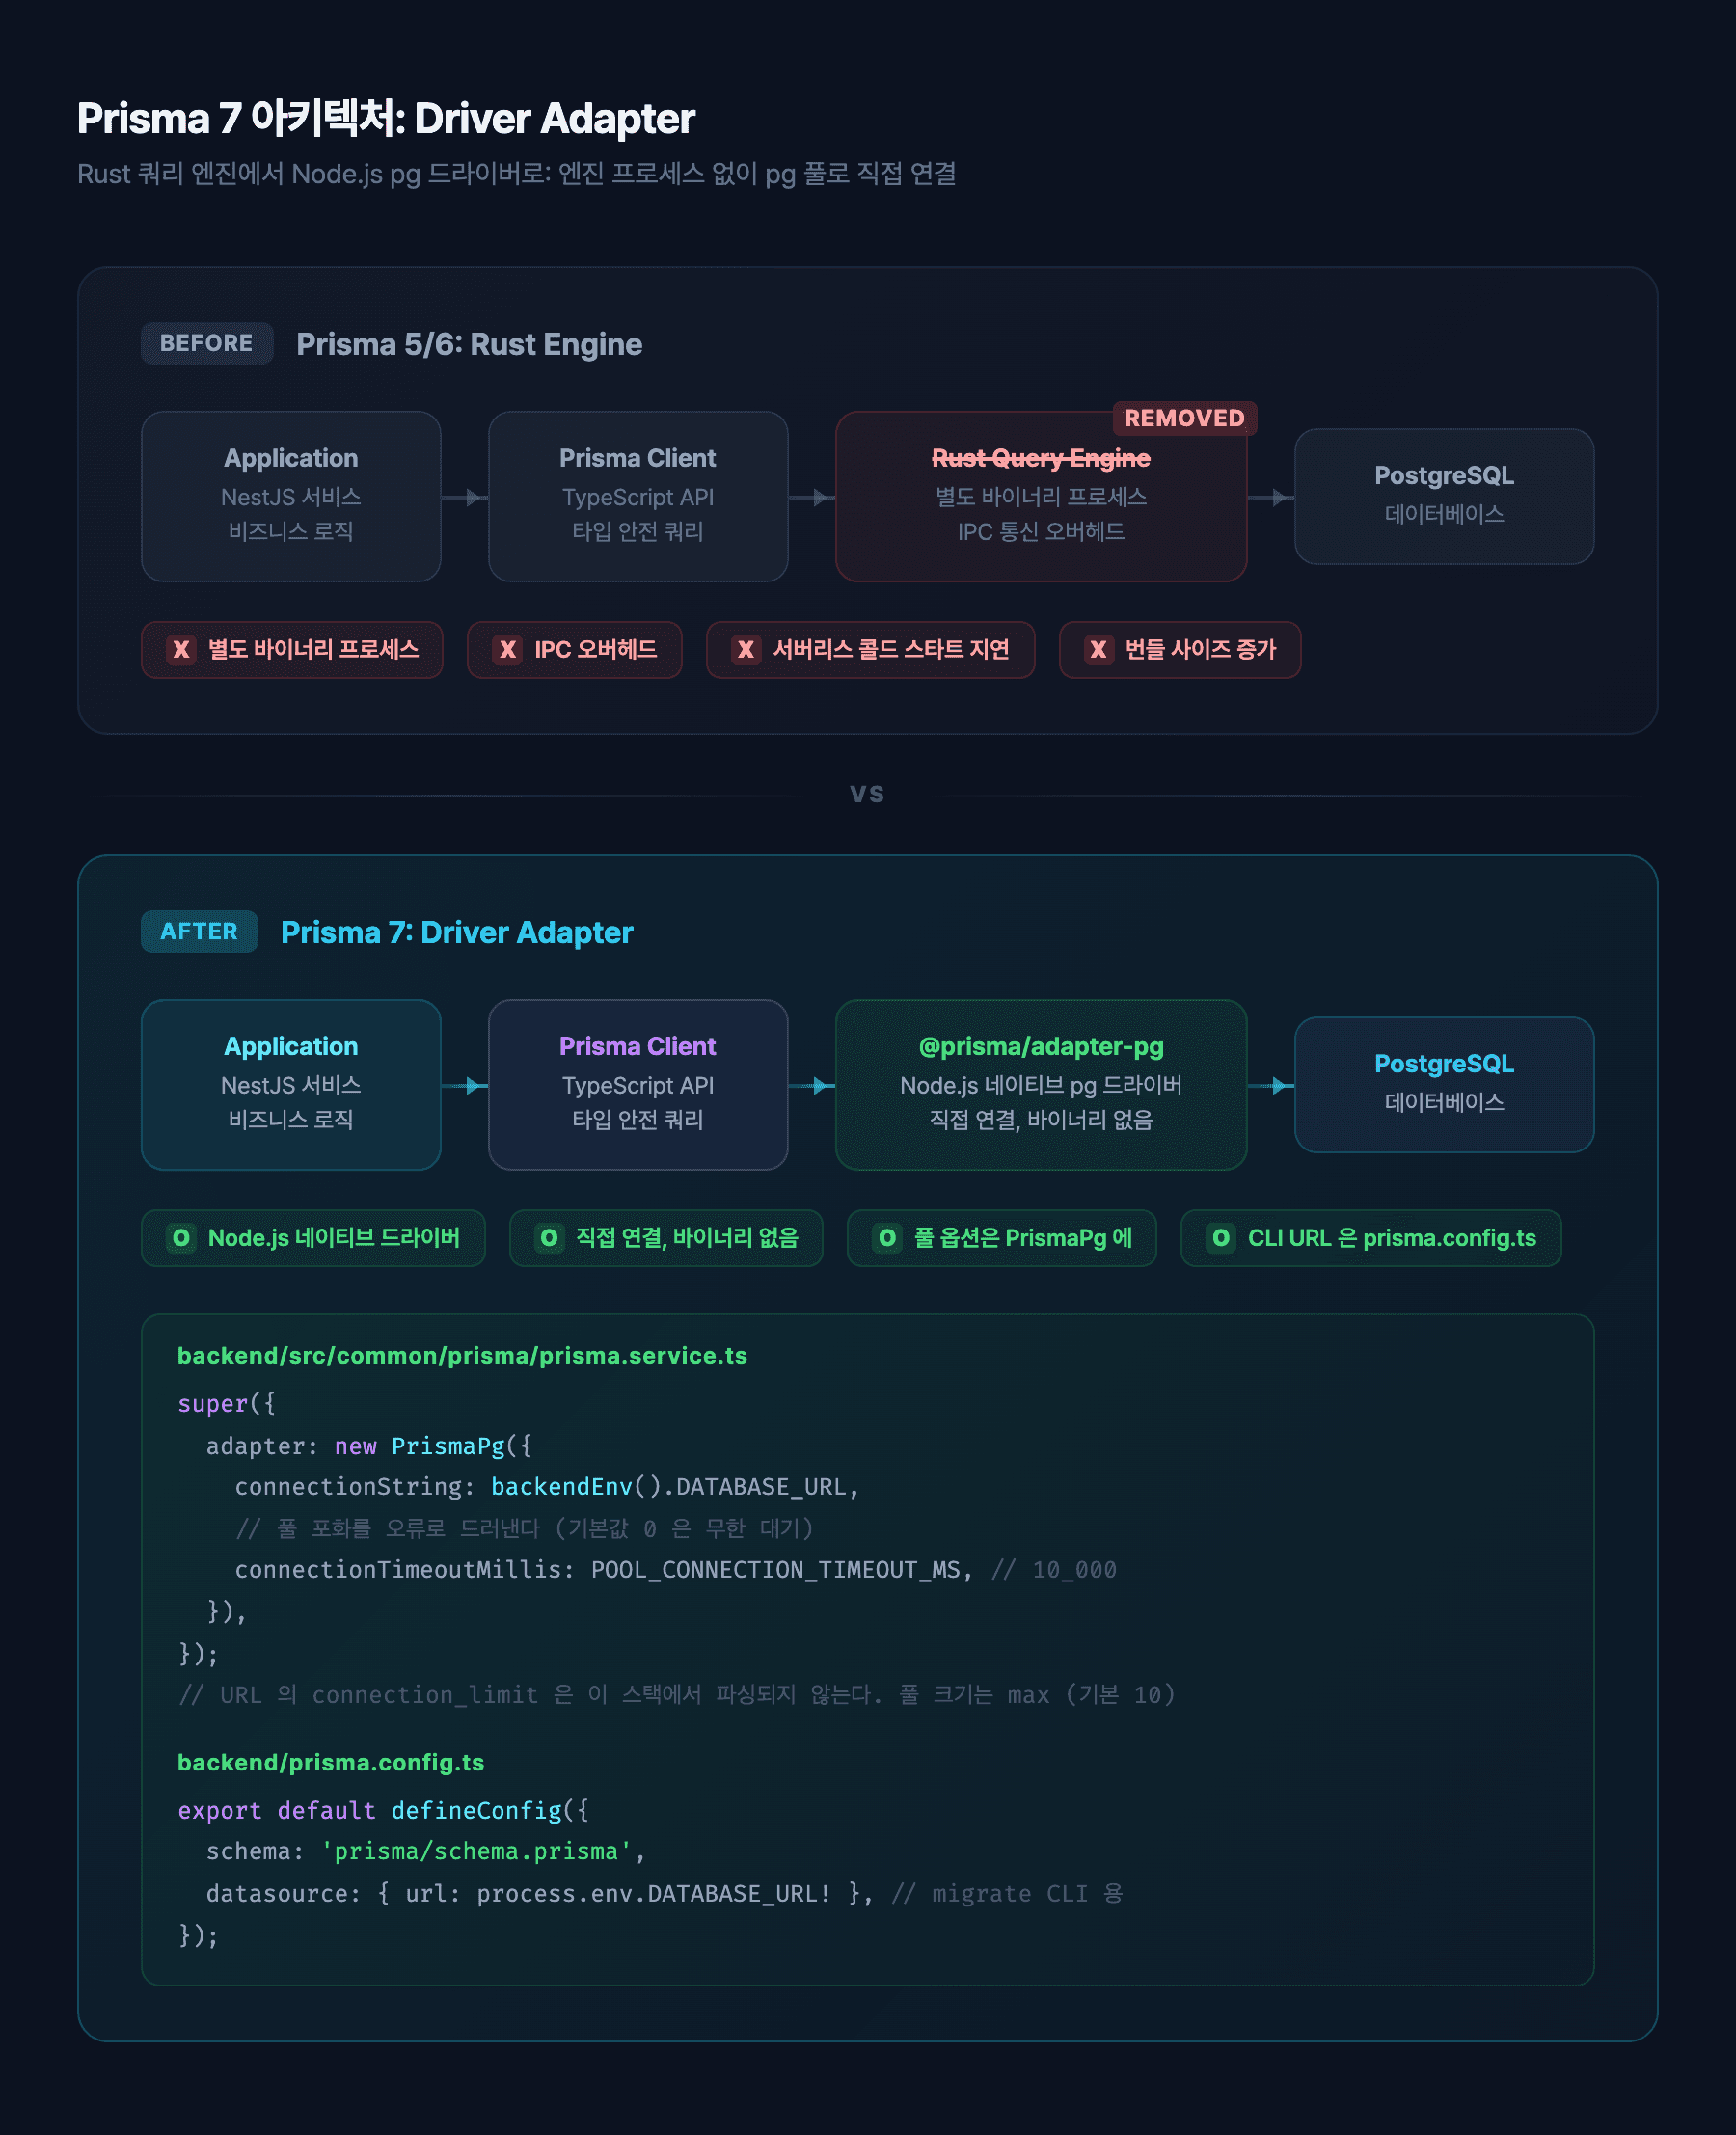
Prisma 7의 가장 큰 변화는 driver adapter다. 이전 메이저까지는 Rust로 작성된 쿼리 엔진이 기본값이었고 DB 커넥션도 그 엔진이 관리했다. Prisma 7은 이 자리를 Node.js 드라이버(pg, mysql2 등)가 대신한다. 엔진 바이너리가 빠지고, 커넥션 풀링은 그 드라이버의 풀을 그대로 쓴다.
Plit의 PrismaService에서 driver adapter를 설정하는 코드는 이렇다.
// backend/src/common/prisma/prisma.service.ts
import { PrismaPg } from '@prisma/adapter-pg';
import { backendEnv } from '../../config/backend-env';
import { PrismaClient } from '../../generated/prisma/client.js';

/** 풀에서 커넥션을 못 받았을 때 기다릴 시간. 넘기면 던진다. */
const POOL_CONNECTION_TIMEOUT_MS = 10_000;

@Injectable()
export class PrismaService
  extends PrismaClient
  implements OnModuleInit, OnModuleDestroy
{
  constructor() {
    super({
      adapter: new PrismaPg({
        connectionString: backendEnv().DATABASE_URL,
        // 풀 포화를 오류로 드러낸다. 기본값 0 은 무한 대기라 포화가 느린 응답으로만
        // 보이고 원인이 안 잡힌다. 풀 크기를 바꿀 자리도 여기다 (`max`, 기본 10).
        // DATABASE_URL 의 `connection_limit` 은 이 어댑터 스택에서 파싱되지 않는다.
        connectionTimeoutMillis: POOL_CONNECTION_TIMEOUT_MS,
      }),
    });
  }

  async onModuleInit() {
    await this.$connect();
  }

  async onModuleDestroy() {
    await this.$disconnect();
  }
}
@prisma/adapter-pg가 pg 패키지를 래핑해 Prisma에 넘긴다. package.json에 pg가 명시적 의존성으로 들어가야 하는데, 이걸 놓치기 쉽다. 기존에 pg를 직접 쓰지 않았다면 pnpm add pg @types/pg를 잊지 말자.
주석에 적힌 두 가지가 실제로 밟은 함정이다. 첫째, 풀 크기 손잡이가 옮겨졌다. 예전처럼 DATABASE_URL 뒤에 ?connection_limit= 을 붙여도 이 스택에서는 아무 일도 일어나지 않고, 에러도 나지 않는다. 풀은 PrismaPg 에 넘기는 pg 옵션(max)이 정한다. 둘째, pg 풀의 connectionTimeoutMillis 기본값 0은 "무한 대기"다. 풀이 꽉 차면 요청이 실패하지 않고 그냥 느려지기만 해서 원인을 찾기 어렵다. 그래서 10초를 넘기면 던지게 했다.
환경변수를 process.env 로 직접 읽지 않는 것도 Plit의 규칙이다. 키는 @plit/shared 의 매니페스트에 선언하고, 백엔드는 backendEnv() 로만 읽는다.
생성 클라이언트의 위치도 달라졌다. schema.prisma에서 출력 경로를 지정한다.
// backend/prisma/schema.prisma
generator client {
  provider     = "prisma-client"
  output       = "../src/generated/prisma"
  moduleFormat = "cjs"
}

datasource db {
  provider = "postgresql"
  schemas  = ["public", "account", "content", "chat", "memory", "safety", "billing", "engagement", "ops"]
}
Prisma 7에서 provider가 prisma-client-js에서 prisma-client로 바뀌었다. output으로 지정한 src/generated/prisma/는 .gitignore에 넣고, 빌드 스크립트에서 prisma generate가 먼저 돌게 한다. datasource 에 접속 URL이 없는 것도 눈여겨볼 대목이다. Plit은 마이그레이션 CLI가 쓰는 URL을 backend/prisma.config.ts 의 defineConfig({ datasource: { url } }) 에 두고, 런타임 접속은 위의 어댑터가 맡는다. schemas 는 테이블을 도메인별 PostgreSQL 스키마 9개로 나눈 흔적이다(핵심 6).
// backend/package.json
{
  "scripts": {
    "build": "prisma generate && nest build"
  }
}
Jest 호환성 문제도 있다. 생성 클라이언트의 import 경로에 .js 확장자가 붙는데, Jest의 ts-jest는 이걸 해석하지 못한다. moduleNameMapper로 .js를 떼어내야 한다.
// backend/package.json: Jest 설정
{
  "jest": {
    "moduleNameMapper": {
      "^(\\.{1,2}/.*)\\.js$": "$1"
    }
  }
}
이 한 줄이 없으면 Cannot find module '../../generated/prisma/client.js' 에러가 난다. Prisma 7 마이그레이션 가이드에도 나오는 이야기지만, 막상 마주치면 원인을 찾는 데 시간이 걸린다.
핵심 2: migrate deploy vs migrate dev, pgvector 인덱스가 사라지는 이유
Plit의 make dev 스크립트는 prisma migrate deploy를 쓴다. prisma migrate dev가 아니다.
#!/usr/bin/env bash
# scripts/start_dev.sh (발췌)
set -e
cd "$(dirname "$0")/.."

bash scripts/ensure_db.sh
bash scripts/ensure_redis.sh
pnpm --filter @plit/shared build

# 4. Run Prisma migrations (deploy, not dev: avoids drift detection for pgvector index)
cd backend
npx prisma migrate deploy

pnpm run start:dev
migrate dev는 마이그레이션 이력과 Prisma 스키마, 현재 DB를 비교한다. 문제는 pgvector의 HNSW 인덱스를 Prisma가 스키마로 표현하지 못한다는 데 있다. 벡터 컬럼은 Unsupported("vector(768)") 로만 선언할 수 있고, 그 위의 인덱스는 schema.prisma 어디에도 적을 자리가 없다.
그래서 인덱스는 마이그레이션 SQL에 손으로 쓴다. 지금 기억 테이블의 인덱스는 이렇게 만들어졌다.
-- backend/prisma/migrations/20260817000000_add_user_memory_ownership/migration.sql (발췌)
-- Prisma 는 Unsupported("vector(768)") 컬럼 위의 인덱스를 스키마로 표현하지 못하므로 손으로 만든다.
CREATE INDEX IF NOT EXISTS "user_memories_embedding_idx"
  ON "user_memories" USING hnsw ("embedding" vector_cosine_ops);

CREATE INDEX IF NOT EXISTS "user_memories_search_vector_idx"
  ON "user_memories" USING gin ("search_vector");
이 마이그레이션 자체는 잘 적용된다. 문제는 그다음이다. Prisma 입장에서 이 인덱스는 "스키마에 없는데 DB에 있는 것"이다. 그래서 migrate dev 는 다음 마이그레이션을 만들 때마다 그 차이를 메우려고 DROP INDEX 를 SQL에 끼워 넣는다. --create-only 로 SQL만 만들어도 diff 계산은 똑같이 일어나므로 이 줄이 들어간다. 드리프트를 크게 보면 DB를 리셋하자고 묻기도 하는데, 개발 중에 yes를 누르면 데이터가 날아간다.
초기에는 "새 마이그레이션은 migrate dev --create-only 로 만들고 적용은 deploy 로" 라는 규칙이면 충분하다고 봤다. 실제로는 부족했다. DROP INDEX 는 벡터와 무관한 마이그레이션에도 섞여 들어가서, 리뷰에서 눈으로 걸러 내기가 어렵다. 게다가 인덱스가 사라져도 에러는 하나도 나지 않는다. 인덱스가 없어도 ORDER BY embedding <=> ... 는 순차 스캔으로 정답을 내기 때문이다.
그래서 지금은 사람의 주의 대신 배포 게이트가 막는다. Render pre-deploy 스크립트(backend/scripts/pre-deploy.sh)가 migrate deploy 직전에 backend/scripts/check-vector-indexes.mjs 를 돌린다. 마이그레이션 디렉토리를 적용 순서대로 훑어 *_embedding_idx 에 대한 마지막 구문이 DROP 인 인덱스가 하나라도 있으면 배포를 멈춘다.
// backend/scripts/check-vector-indexes.mjs (발췌)
const INDEX_STATEMENT = /\b(CREATE|DROP)\s+INDEX\s+(?:IF\s+(?:NOT\s+)?EXISTS\s+)?(?:"?\w+"?\s*\.\s*)?"?([\w]*_embedding_idx)"?/gi;

for (const migration of migrations) {
  // ...
  for (const [, verb, index] of sql.matchAll(INDEX_STATEMENT)) {
    lastAction.set(index, { verb: verb.toUpperCase(), migration });
  }
}

const dropped = [...lastAction.entries()].filter(([, action]) => action.verb === 'DROP');
쓰는 자리는 이렇게 갈린다.
- 개발 서버 시작:
prisma migrate deploy(드리프트 검사 없이 미적용분만 실행) - 새 마이그레이션 생성:
prisma migrate dev --create-only로 SQL을 만든 뒤, 생성된 SQL에서 벡터 인덱스DROP INDEX를 지운다 - 배포: pre-deploy 의
check-vector-indexes.mjs가 통과해야prisma migrate deploy가 돈다
이 문제는 pgvector에만 해당하지 않는다. tsvector 컬럼의 GIN 인덱스처럼 Prisma가 표현하지 못하는 인덱스라면 같은 방식으로 지워진다. 수동 SQL로 만든 인덱스가 있다면 그 인덱스가 "마지막에 CREATE 로 끝나는지"를 기계로 확인하는 장치가 필요하다.
핵심 3: PostgreSQL 18, 기대와 실제
PostgreSQL 18로 올리면서 기대한 기능은 셋이었다. 비동기 I/O(AIO), 내장 uuidv7(), B-tree skip scan이다. 지금 코드를 기준으로 보면 Plit이 실제로 기대고 있는 것은 아직 없다. 기대가 어디서 빗나갔는지가 오히려 배울 거리라 정리해 둔다.
AIO: 18에서 들어온 범위는 HNSW 검색이 아니다
PostgreSQL 18의 큰 구조 변화는 비동기 I/O 서브시스템이다. 읽기 요청 하나가 끝날 때까지 기다리지 않고 여러 읽기를 한꺼번에 내보낸다. 다만 18에서 이 경로를 타는 것은 순차 스캔, 비트맵 힙 스캔, VACUUM 같은 읽기다. pgvector의 HNSW 인덱스 탐색은 그 목록에 없다. 처음에는 "매 턴의 벡터 검색이 빨라질 것"이라고 기대했지만, Plit에서 그 효과를 측정한 적은 없다.
데이터 규모로 봐도 지금은 I/O가 병목이 될 자리가 아니다. 2026년 8월 prod 실측에서 사용자×캐릭터 쌍당 기억은 많아야 10건이었다(backend/src/ai-pipeline/constants/memory.constants.ts 주석). 이 크기에서는 인덱스와 행이 통째로 메모리에 올라간다.
UUIDv7: DB default로는 바뀌지 않는다
PostgreSQL 18은 uuidv7() 함수를 내장한다. 타임스탬프 기반이라 시간순으로 정렬되고, 새 행이 B-tree 끝에 붙으니 랜덤 UUIDv4보다 페이지 분할이 적다.
그런데 Plit의 PK는 전부 String @id @default(uuid()) 이고, 마이그레이션이 만든 컬럼은 "id" TEXT NOT NULL 이다. DB 쪽 default가 없다. @default(uuid()) 는 Prisma가 INSERT 직전에 값을 채우기 때문이다. 그래서 테이블에 ALTER COLUMN id SET DEFAULT uuidv7() 를 걸어도 Prisma를 거치는 INSERT에는 적용되지 않는다. 바꾸려면 Prisma 스키마 쪽에서 바꿔야 하고, 아직 하지 않았다.
Skip scan과 통계 유지
18은 다중 컬럼 B-tree 인덱스에서 선행 컬럼 조건 없이도 인덱스를 타는 skip scan을 지원하고, pg_upgrade 후에도 옵티마이저 통계를 넘겨준다. 둘 다 PostgreSQL의 기능이고, Plit이 그 덕을 본 구체적인 쿼리나 업그레이드 기록은 남아 있지 않다. 그래서 이 글에서는 "있다"까지만 적는다.
핵심 4: @Global() PrismaModule과 모듈 구성
NestJS 11에서 Prisma를 쓰는 패턴은 간단하다. PrismaModule을 @Global()로 선언하면 어느 모듈에서든 PrismaService를 주입받는다.
// backend/src/common/prisma/prisma.module.ts
@Global()
@Module({
  providers: [PrismaService],
  exports: [PrismaService],
})
export class PrismaModule {}
AppModule에서 한 번만 import하면 끝이다. 피처 모듈이 저마다 PrismaModule을 import할 필요가 없다.
// backend/src/app.module.ts (발췌)
@Module({
  imports: [
    SentryModule.forRoot(),
    BackgroundTasksModule,
    PrismaModule,
    RedisModule,
    ResourceUsageConfigModule,
    RateLimitModule,
    EncryptionModule,
    StorageModule,
    EmbeddingModule,
    LlmModelModule,
    AiClientModule,
    AuthModule,
    SessionsModule,
    ChatModule,
    CharactersModule,
    // ... 피처 모듈들
    EventEmitterModule.forRoot(),
    ScheduleModule.forRoot(),
  ],
})
export class AppModule implements NestModule {
  configure(consumer: MiddlewareConsumer) {
    consumer
      .apply(IpRateLimitMiddleware)
      // ...
  }
}
지금 imports 배열에는 69개 항목이 있다. 그중 3개(SentryModule, EventEmitterModule, ScheduleModule 의 forRoot())를 빼면 Plit 자체 모듈이 66개다. ConfigModule 은 없다. 환경변수는 위에서 본 backendEnv() 가 맡는다.
@Global() 이 붙은 모듈은 17개다. 16개는 src/common/ 아래의 인프라(PrismaModule, RedisModule, EncryptionModule, EmbeddingModule, AiClientModule, RateLimitModule 등)이고, 예외 하나가 src/chat/session-sync.module.ts 의 SessionSyncModule 이다. 이 모듈의 서비스는 sessionId 별로 열린 SSE 응답 객체를 프로세스 안 Map 에 들고 있는데, 이 연결 레지스트리는 앱 전체에 하나여야 하므로 전역으로 둔다.
모든 서비스는 생성자 주입으로 PrismaService를 받는다. 트랜잭션이 필요하면 prisma.$transaction()을 쓴다. 재화 로직이 대표적이다. 젬 차감과 거래 기록이 원자적이어야 하기 때문이다.
초기 구현은 조건부 UPDATE 한 줄(UPDATE gem_wallets SET balance = balance - $1 WHERE user_id = $2 AND balance >= $1)로 잔액을 깎았다. 지금은 젬이 만료 시각과 칸(DAILY → FREE → PAID 순으로 차감)을 가진 로트 단위로 쌓인다. 어느 로트에서 얼마를 뺄지는 잔액 컬럼 하나를 조건으로 거는 UPDATE로 표현할 수 없다. 그래서 지갑 행을 잠그고, 잠근 상태에서 계산하고 쓴다.
// backend/src/gems/gem-ledger.service.ts (발췌)
/** 부족하면 402. 이때 트랜잭션이 통째로 되돌아가 로트·캐시는 바뀌지 않는다. */
async spend(
  userId: string,
  amount: number,
  reason: GemTransactionReason,
  referenceId: string | null,
  opts: SpendOptions = {},
  tx?: Tx,
): Promise<LedgerResult> {
  assertPositiveInt(amount, '차감');
  return this.inTx(tx, async (db) => {
    const wallet = await this.lockWallet(userId, db);
    const now = new Date();
    const { active } = await this.settleExpired(wallet.id, now, db);

    const current = spendableTotal(active, now);
    const draws = planSpend(active, amount, now);
    if (!draws) {
      throw new HttpException(
        { message: '젬이 부족합니다', required: amount, current },
        HttpStatus.PAYMENT_REQUIRED,
      );
    }

    const balance = current - amount;
    const transaction = await this.repo.createTransaction(
      { walletId: wallet.id, type: GemTransactionType.CONSUME, amount: -amount, balanceAfter: balance, reason, referenceId, /* ... */ },
      db,
    );
    await this.repo.drawLots(draws, db);
    await this.repo.createAllocations(transaction.id, draws, db);
    await this.repo.setBalance(wallet.id, balance, db);
    return { balance, transaction };
  });
}

private inTx<T>(tx: Tx | undefined, fn: (db: Tx) => Promise<T>): Promise<T> {
  return tx ? fn(tx) : this.prisma.$transaction(fn);
}
// backend/src/gems/repositories/gem-ledger.repository.ts (발췌)
async lockWallet(
  userId: string,
  tx: Prisma.TransactionClient,
): Promise<{ id: string } | null> {
  const rows = await tx.$queryRaw<{ id: string }[]>`
    SELECT id FROM billing.gem_wallets WHERE user_id = ${userId} FOR UPDATE`;
  return rows[0] ?? null;
}
여기서 눈여겨볼 대목은 여전히 트랜잭션 안에서 raw SQL과 Prisma ORM을 섞어 쓴다는 점이다. SELECT ... FOR UPDATE 는 Prisma 쿼리 API에 없으니 tx.$queryRaw 로 쓰고, 로트 조회와 거래 기록은 ORM으로 쓴다. 같은 tx 를 넘기기만 하면 둘이 한 트랜잭션에 묶인다. inTx 는 호출자가 이미 연 트랜잭션이 있으면 그 안에서 돌고, 없으면 새로 연다. 같은 원장의 지급(grant)도 inTx 를 거치는데, 결제 확정 흐름이 결제 상태 전이와 젬 지급을 한 트랜잭션으로 묶을 때 바깥 tx 를 넘기는 쪽을 탄다.
두 가지를 덧붙인다. raw SQL은 $queryRawUnsafe 대신 태그드 템플릿 형태의 $queryRaw 로 쓴다. ${userId} 가 문자열로 이어 붙지 않고 바인드 파라미터가 된다. 그리고 단가는 코드 상수가 아니다. GemsService.consume() 은 ResourceUsageConfigService.getGemCost(reason) 로 DB의 설정 행을 읽어 금액을 정한 뒤 spend() 를 부른다. 어드민 화면에서 배포 없이 단가를 바꾸기 위해서다.
인터랙티브 트랜잭션의 기본 타임아웃은 5초라서, 오래 걸리는 작업은 옵션을 따로 준다(예: admin-content-io.service.ts 의 { maxWait: 10_000, timeout: 60_000 }).
서로 독립적인 쓰기 여러 개를 묶을 때는 배열 기반 트랜잭션을 쓴다.
// backend/src/home/repositories/home-banner.repository.ts (발췌)
/** 배열 순서를 그대로 1..N 으로 다시 매긴다. 트랜잭션은 호출부가 연다. */
reorderOps(ids: string[]): Prisma.PrismaPromise<unknown>[] {
  return ids.map((id, index) =>
    this.prisma.homeBanner.update({
      where: { id },
      data: { sortOrder: index + 1 },
    }),
  );
}

async runInTransaction(ops: Prisma.PrismaPromise<unknown>[]): Promise<void> {
  await this.prisma.$transaction(ops);
}
홈 배너 순서를 한 번에 다시 매긴다. 앞 쿼리의 결과를 다음 쿼리가 읽을 필요가 없으니 인터랙티브 트랜잭션보다 가볍게 끝난다.
핵심 5: pgvector와 raw SQL의 공존
Prisma는 PostgreSQL의 vector 타입을 네이티브로 지원하지 않는다. 스키마에서는 Unsupported로 선언한다.
// backend/prisma/schema.prisma (발췌)
/// 사용자 소유 기억. 어느 캐릭터의 기억인지는 UserMemoryCharacter 조인이 정한다.
model UserMemory {
  id                String                      @id @default(uuid())
  userId            String                      @map("user_id")
  summary           String                      @db.Text
  /// 추출이 매긴 중요도 1~10. 상시 주입 슬롯과 팩트 축출 순서가 이 값으로 갈린다
  importance        Int                         @default(5)
  embedding         Unsupported("vector(768)")?
  searchVector      Unsupported("tsvector")?    @map("search_vector")
  // ...

  @@map("user_memories")
  @@schema("memory")
}
Unsupported 타입은 "이 컬럼은 Prisma 클라이언트로 다루지 않는다"는 선언이다. 컬럼은 마이그레이션에 생기지만, 그 위의 인덱스는 수동 SQL 몫이고(핵심 2), findMany나 create에서 이 필드는 읽지도 쓰지도 못한다.
기억의 소유 단위도 바뀌었다. 초기에는 세션마다 session_memories 에 기억을 쌓았지만, 지금은 사용자×캐릭터 단위의 user_memories 가 기억을 갖는다. 세션을 새로 열어도 같은 캐릭터와의 기억이 이어지게 하기 위해서다. 옛 테이블은 백필 후 20260820110000_drop_session_memories 에서 지웠다. 기억은 그 사용자×캐릭터 쌍에 유저 메시지가 5개 쌓일 때마다 요약으로 만들어진다(MEMORY_GENERATION_THRESHOLD). 남길 내용이 없으면 만들지 않는다.
벡터 관련 작업은 전부 raw SQL이고, raw SQL은 리포지토리 파일에만 둔다. 아키텍처 게이트(scripts/check-arch-rules.sh 의 R3)가 *.repository.ts 밖에 새로 추가된 $queryRaw / $executeRaw 를 커밋 단계에서 막는다.
임베딩 저장: 기억 행을 커밋한 뒤 Gemini(gemini-embedding-2-preview, 768차원)로 요약을 임베딩해 vector(768) 컬럼에 넣는다. 처음에는 Voyage AI의 512차원 임베딩을 썼고, 20260404170000_migrate_embedding_to_768 에서 컬럼 타입을 바꾸며 기존 벡터를 비웠다.
// backend/src/ai-pipeline/services/memory.service.ts (발췌)
// 시맨틱 검색(pgvector)을 위해 벡터 임베딩 저장. 행은 이미 커밋됐으니 데드라인을
// 넘겨도 중단하지 않는다. 색인을 건너뛰면 이 기억이 두 검색 경로에서 다 사라진다.
const embedding = await this.withDeadline(
  this.embedding.embed(parsed.summary),
  deadline.signal,
  sessionId,
).catch(() => null);
if (embedding) {
  await this.userMemory.updateEmbedding(
    memoryId,
    `[${embedding.join(',')}]`,
  );
}
// backend/src/ai-pipeline/repositories/user-memory.repository.ts (발췌)
async updateEmbedding(memoryId: string, vectorStr: string): Promise<void> {
  await this.prisma.$executeRaw`
    UPDATE memory."user_memories" SET "embedding" = ${vectorStr}::vector WHERE "id" = ${memoryId}`;
}
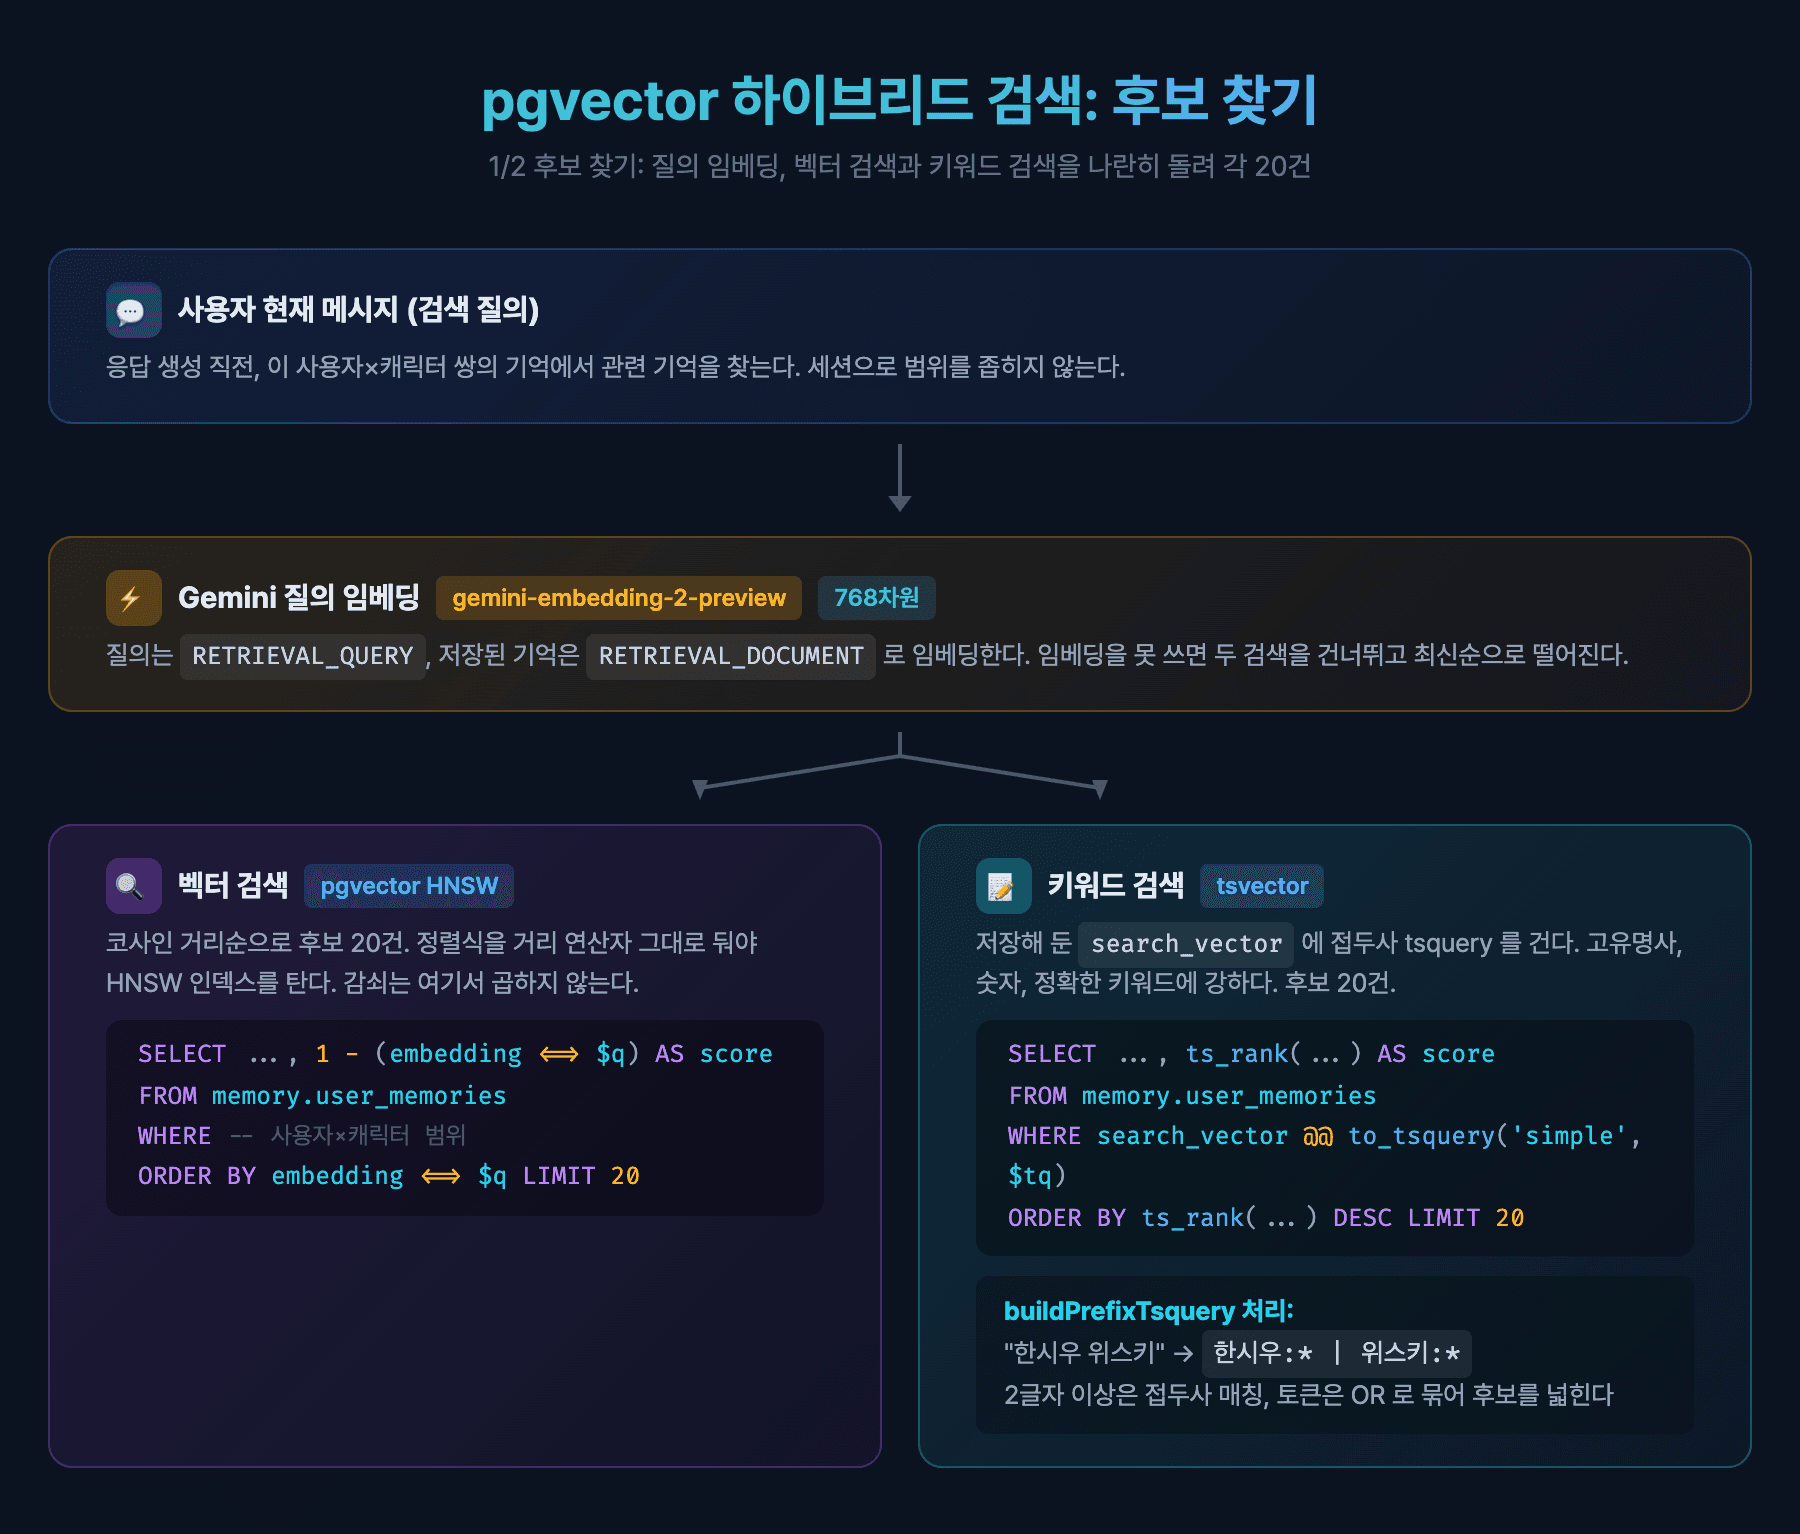
코사인 유사도 검색: pgvector의 <=> 연산자를 쓴다. 범위는 세션이 아니라 사용자×캐릭터다.
// backend/src/ai-pipeline/repositories/user-memory.repository.ts (발췌)
async findVectorResults(
  userId: string,
  characterIds: string[],
  sourceModes: string[],
  vectorStr: string,
  limit: number,
  sessionIdFilter?: string,
): Promise<UserMemoryRow[]> {
  return this.prisma.$queryRaw<UserMemoryRow[]>(Prisma.sql`
    SELECT ${this.selectColumns()},
           1 - (um."embedding" <=> ${vectorStr}::vector) AS "score"
    FROM memory."user_memories" um
    ${this.seqLateral(characterIds)}
    WHERE ${this.scopeClause(userId, sourceModes, sessionIdFilter)}
      AND um."embedding" IS NOT NULL
    ORDER BY um."embedding" <=> ${vectorStr}::vector ASC
    LIMIT ${limit}`);
}
<=> 연산자는 코사인 거리를 반환한다(0 = 동일, 2 = 정반대). 1 - distance 로 유사도로 바꿔 score 로 돌려준다.
이 쿼리에서 가장 중요한 줄은 ORDER BY 다. 초기 버전은 ORDER BY (1 - (embedding <=> $2::vector)) * EXP(-0.693 * 경과일) 처럼 유사도에 시간 감쇠를 곱한 식으로 정렬했다. 그런데 HNSW 인덱스는 ORDER BY 컬럼 <=> 상수 모양의 정렬에만 쓰인다. 거리에 무언가를 곱하는 순간 플래너는 인덱스를 쓸 수 없고 전체 행의 점수를 계산해 정렬한다. 그래서 지금은 SQL이 거리순으로 후보를 넉넉히(MEMORY_SEARCH_OVERFETCH = 20) 가져오고, 감쇠는 애플리케이션이 그 후보 위에서만 곱한다.
// backend/src/ai-pipeline/services/memory-retrieval.service.ts (발췌)
/**
 * 시퀀스 감쇠 재랭킹.
 *
 * SQL 이 아니라 여기서 곱한다. 감쇠식으로 정렬하면 pgvector HNSW 인덱스를 타지 못한다.
 * over-fetch 한 후보 위에서만 순서를 바꾸므로 인덱스는 그대로 쓰인다.
 */
static rerankBySequence(rows: MemoryResult[], maxSeq: number): MemoryResult[] {
  return [...rows]
    .map((row) => ({
      row,
      score: row.score * MemoryRetrievalService.sequenceDecay(row, maxSeq),
    }))
    .sort((a, b) => b.score - a.score)
    .map((e) => e.row);
}

static sequenceDecay(
  memory: Pick<MemoryResult, 'seq' | 'pinnedAt'>,
  maxSeq: number,
): number {
  if (memory.pinnedAt) return 1;
  const distance = Math.max(0, maxSeq - memory.seq);
  return Math.max(SEQ_DECAY_FLOOR, 2 ** (-distance / SEQ_DECAY_HALF_LIFE));
}
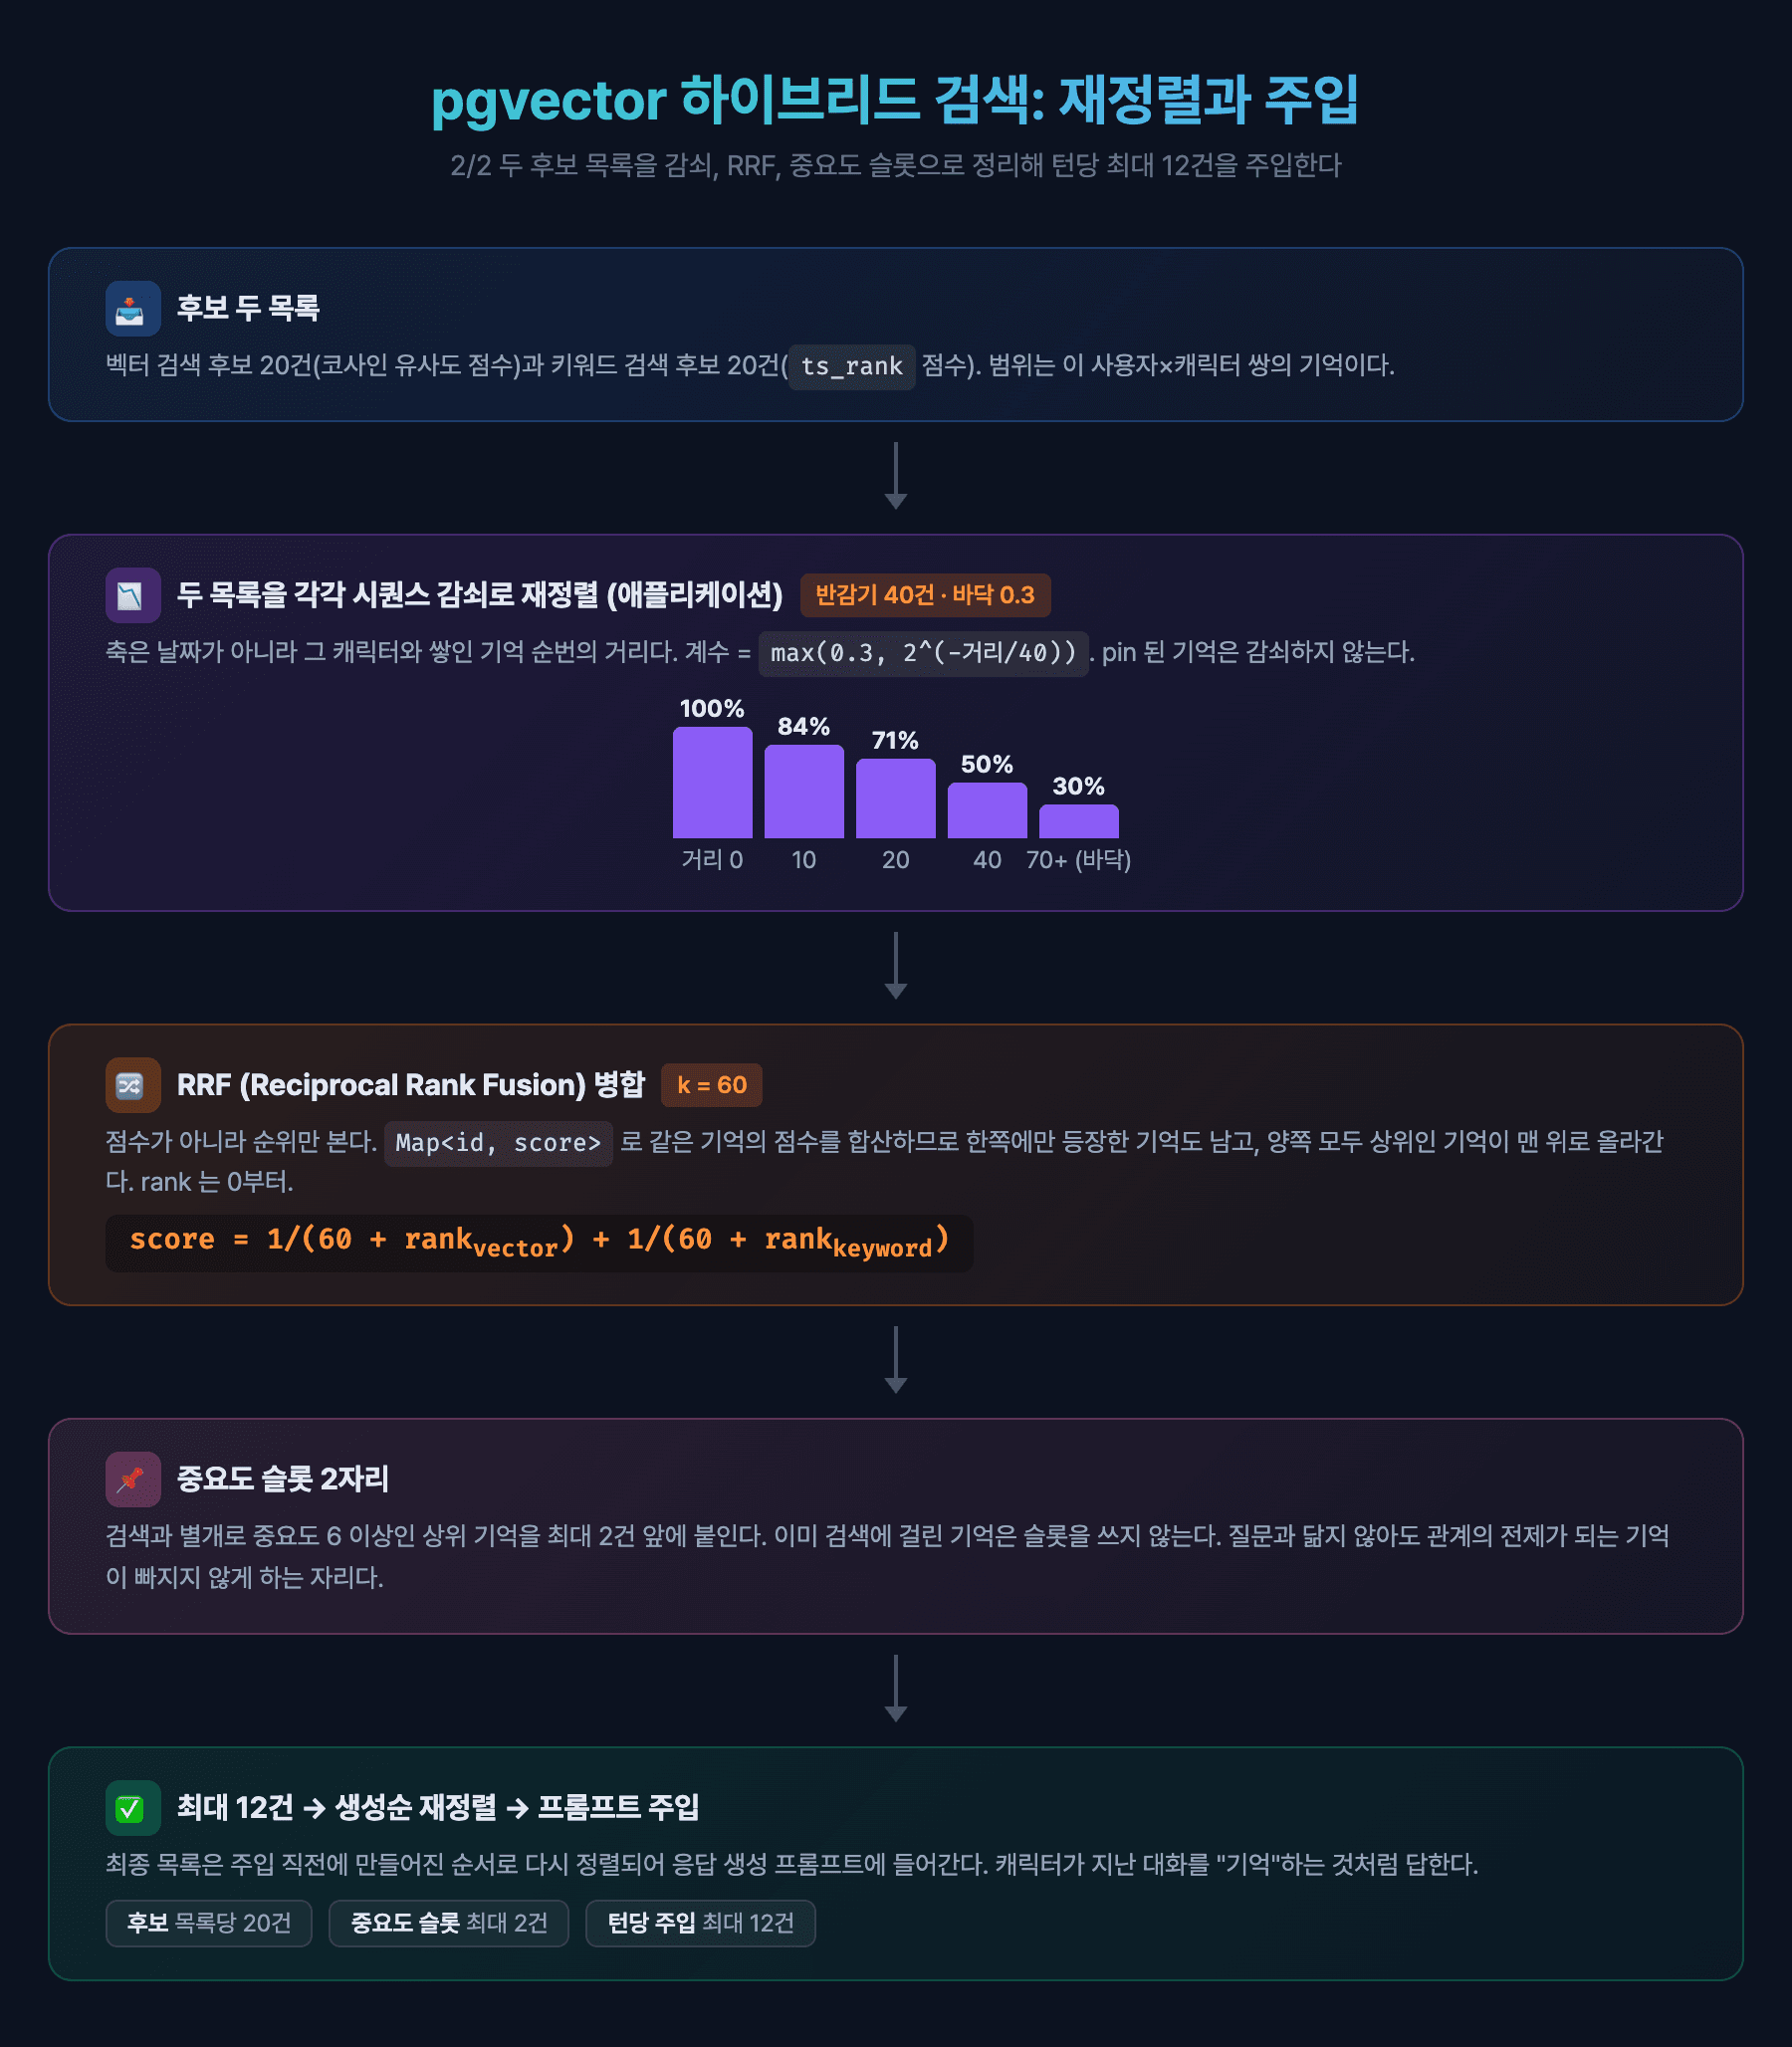
감쇠의 축도 바뀌었다. 초기에는 반감기 1일의 시간 감쇠였다. 그러면 며칠 쉬었다 돌아온 사용자의 기억이 통째로 0에 가까워진다. 지금은 그 캐릭터와 쌓인 기억 개수(seq)를 축으로 쓴다. 반감기는 기억 40건(SEQ_DECAY_HALF_LIFE)이고, 바닥값 0.3(SEQ_DECAY_FLOOR) 아래로는 떨어지지 않는다. 바닥이 없으면 멀어진 기억이 전부 0으로 수렴해 유사도 차이가 지워지기 때문이다.
하이브리드 검색: 벡터 검색(의미)과 tsvector 검색(키워드)을 Reciprocal Rank Fusion(RRF) 으로 합친다. 키워드 쪽은 search_vector @@ to_tsquery('simple', ...) 로 찾는데, simple 토크나이저가 한국어 조사를 떼지 못하므로 buildPrefixTsquery() 가 2글자 이상 토큰에 접두사 매칭(:*)을 붙이고 토큰을 OR(|)로 묶는다. 두 목록은 각각 시퀀스 감쇠로 재정렬한 뒤 RRF로 합친다.
// backend/src/ai-pipeline/services/memory-retrieval.service.ts (발췌)
/** 벡터·텍스트 RRF. 같은 후보 집합을 두 랭커가 매긴 것이라 순위끼리 비교된다. */
static mergeByRRF(
  vectorResults: MemoryResult[],
  textResults: MemoryResult[],
  limit: number,
  k = 60,
): MemoryResult[] {
  const scoreMap = new Map<string, { score: number; item: MemoryResult }>();

  for (let i = 0; i < vectorResults.length; i++) {
    const r = vectorResults[i];
    scoreMap.set(r.id, { score: 1 / (k + i), item: r });
  }

  for (let i = 0; i < textResults.length; i++) {
    const r = textResults[i];
    const existing = scoreMap.get(r.id);
    if (existing) {
      existing.score += 1 / (k + i);
    } else {
      scoreMap.set(r.id, { score: 1 / (k + i), item: r });
    }
  }

  return Array.from(scoreMap.values())
    .sort((a, b) => b.score - a.score)
    .slice(0, limit)
    .map((e) => e.item);
}
벡터 검색은 "비슷한 맥락"을 잡고, tsvector 검색은 "정확한 키워드"를 잡는다. RRF는 점수가 아니라 순위만 보므로, 단위가 다른 코사인 유사도와 ts_rank 를 억지로 정규화할 필요가 없다.
검색만으로 끝나지 않는다. 한 턴에 주입하는 기억은 최대 12건인데, 그중 최대 2자리(IMPORTANCE_RESERVED_SLOTS)는 검색을 거치지 않고 중요도 6 이상(IMPORTANCE_SLOT_FLOOR)인 상위 기억에 떼어 준다. 고백한 날의 기억이 이번 질문과 닮지 않았다는 이유로 빠지면, 관계가 어디까지 왔는지가 프롬프트에서 사라지기 때문이다. 임베딩 키가 없으면 벡터와 키워드 검색을 건너뛰고 최신순으로 떨어진다. 최종 목록은 주입 직전에 생성순으로 다시 정렬된다(ai-pipeline.service.ts).
핵심 6: 모델 97개와 enum 63개의 스키마 설계 패턴
Plit의 스키마(backend/prisma/schema.prisma)는 지금 모델 97개와 enum 63개로 이뤄져 있다. 이 숫자는 금방 낡으므로 필요할 때 grep -c '^model ' / grep -c '^enum ' 로 세는 것이 낫다. 규모가 커지면서 테이블은 PostgreSQL 스키마 9개(account, content, chat, memory, safety, billing, engagement, ops, public)로 나눴다. 모델마다 @@schema("chat") 처럼 소속을 적는다. raw SQL에서 memory."user_memories", billing.gem_wallets 처럼 스키마를 앞에 붙여 쓰는 이유가 이것이다. 반복해서 쓴 패턴 몇 가지를 정리한다.
JSON으로 유연한 상태 관리. 구조가 자주 바뀌는 데이터는 Json 컬럼(PostgreSQL에서는 jsonb)에 넣는다.
// backend/prisma/schema.prisma (발췌)
model Character {
  persona  Json? // 런타임은 { personality } 만 읽는다. 말투 키는 speechStyle 컬럼 소관이고 여기 남은 것은 레거시
  identity Json? // { backstory, core_traits[], motivation, flaw, archetype }
  safety   Json? // { never_do[], always_do[], escalation_response }

  speechStyle Json?   @map("speech_style")
  // ...
}

model PlaySession {
  characterChatId        String?    @map("character_chat_id")
  stateJson              Json?      @map("state_json")
  // ...
}

model ChatMessage {
  affinitySnapshot   Json?    @map("affinity_snapshot")
  // ...
}
Character 의 JSON 필드는 AI 프롬프트의 캐릭터 프로필로 들어가는 구조화 데이터다. 필드가 늘어도 마이그레이션이 필요 없다. 대가도 있다. persona 주석처럼 한때 JSON 안에 있던 말투 키가 별도 컬럼(speechStyle)으로 옮겨 가면 옛 키가 JSON 안에 레거시로 남는다. 스키마가 검사해 주지 않으니 어떤 키를 런타임이 읽는지를 주석으로 적어 둬야 한다. ChatMessage.affinitySnapshot 은 되감기 기능을 받치는 스냅샷이다. 메시지마다 그 시점의 호감도를 적어 두면 되감을 때 그 시점으로 복원한다(ChatService.rewindToMessage).
Enum 중심의 타입 안전성. 문자열 대신 enum을 쓰면 Prisma 클라이언트가 타입을 검사한다.
// backend/prisma/schema.prisma (발췌)
enum ContentAudience {
  MALE_ORIENTED
  FEMALE_ORIENTED
  ALL

  @@schema("public")
}

enum GemTransactionReason {
  PURCHASE
  SUBSCRIPTION_MONTHLY
  REWIND
  CHAT_MESSAGE
  IMAGE_GENERATION
  CHAT_RESET
  EXPIRY
  // ...
}
TypeScript에서 GemTransactionReason.CHAT_MESSAGE처럼 쓰면 오타가 컴파일 타임에 잡힌다. 프론트엔드도 같은 값을 써야 하므로, 양쪽이 공유하는 enum은 @plit/shared(packages/shared/src/enums.ts)에 같은 값의 상수 객체로 두고 한국어 라벨도 그 패키지에 함께 둔다. 예를 들어 ContentAudience 는 사용자가 고르는 성향 축이고, 라벨은 여성향(남성 캐릭터 중심), 남성향(여성 캐릭터 중심), 전체 다.
@map으로 snake_case 매핑. TypeScript는 camelCase, PostgreSQL은 snake_case가 관례다. Prisma의 @map이 양쪽 관례를 동시에 지켜준다.
// backend/prisma/schema.prisma (발췌)
model CharacterChat {
  id          String   @id @default(uuid())
  userId      String   @map("user_id")
  characterId String   @map("character_id")

  // 유저가 이 캐릭터에서 고른 값. null 은 users 의 전역 기본값으로 폴백한다.
  startAffinityLevel Int?    @map("start_affinity_level")
  growthPreset       String? @map("growth_preset")

  character Character     @relation(fields: [characterId], references: [id], onDelete: Cascade)
  sessions  PlaySession[]

  @@unique([userId, characterId])
  @@index([userId])
  @@map("character_chats")
  @@schema("chat")
}
TypeScript 코드에서는 characterChat.startAffinityLevel 로, SQL 쿼리에서는 start_affinity_level 로 접근한다. raw SQL과 ORM을 섞어 쓰는 프로젝트에서 이 일관성이 중요하다.
관계 상태는 캐릭터 원본 밖에 둔다. 캐릭터는 독립 엔티티다. 한 사용자와 한 캐릭터 사이에 쌓이는 것은 캐릭터 행이 아니라 (userId, characterId) 를 유니크 키로 갖는 옆 테이블이 맡는다. 위의 CharacterChat 이 그 대화방이고, 호감도 점수와 레벨은 같은 키를 쓰는 CharacterAffinity 가, 기억은 user_memories 가 갖는다. 세션(PlaySession)은 characterChatId 에만 매달린다. 그래서 "새 대화"로 세션을 새로 열어도 호감도와 기억은 그대로 남고, 캐릭터 원본은 어느 사용자의 대화에도 오염되지 않는다.
정리
Prisma 7 + NestJS 11 + PostgreSQL 18 + pgvector를 실전에 올리며 확인한 판단들이다.
-
Prisma 7의 driver adapter는 실전에서 안정적이지만, 풀 설정의 자리가 옮겨졌다.
@prisma/adapter-pg로pg드라이버를 직접 쓰면 엔진 바이너리가 사라진다. 풀 크기와 대기 시간은PrismaPg에 넘기는 옵션이 정하고, URL의connection_limit은 조용히 무시된다.pg를 명시적 의존성으로 추가하는 것, Jest의moduleNameMapper설정도 잊지 말자. -
pgvector를 쓰면
migrate deploy를 기본으로 삼고, 인덱스 생존을 기계로 확인하라.migrate dev(그리고--create-only)는 Prisma가 표현하지 못하는 HNSW 인덱스에 대해DROP INDEX를 만들어 내고, 인덱스가 사라져도 에러가 나지 않는다. 사람의 주의 대신 pre-deploy 의check-vector-indexes.mjs같은 기계 검사로 막는다. -
새 버전의 기능은 우리 쿼리가 실제로 그 경로를 타는지부터 확인하라. PostgreSQL 18의 AIO는 순차 스캔 같은 읽기부터 적용됐고 HNSW 탐색은 범위 밖이다.
uuidv7()도 Prisma가 id를 채우는 한 DB default로는 효과가 없다. -
Unsupported타입은 "Prisma의 영역 밖"이라는 선언이다. 벡터 컬럼의 인덱싱과 검색은 수동 SQL 몫이고, Plit은 그 SQL을 리포지토리 파일에만 두도록 게이트로 묶었다. 그리고 HNSW 인덱스를 타려면ORDER BY는 거리 연산자 그대로여야 한다. 가중치는 넉넉히 가져온 후보 위에서 애플리케이션이 곱한다. -
@Global()모듈은 인프라 서비스로 제한하라. Plit의 전역 모듈 17개 중 16개는src/common/의 인프라이고, 예외는 앱 전체에 하나여야 하는 SSE 연결 레지스트리 하나다. 도메인 서비스까지 글로벌로 열면 의존성 추적이 불가능해진다. -
트랜잭션 안에서 raw SQL과 ORM을 섞어 써도 된다. Plit의 젬 원장은
SELECT ... FOR UPDATE로 지갑을 잠그는 raw SQL과 로트·거래 기록을 쓰는 ORM 호출을 같은tx로 묶는다. raw SQL은 태그드 템플릿$queryRaw로 써서 값이 바인드 파라미터로 들어가게 한다. -
JSON + Enum + @map + 스키마 분리: 이 넷이 Prisma 스키마의 핵심 도구다. 유연한 데이터는 JSON, 타입 안전성은 enum(프론트와 공유할 값은
@plit/shared에도), 네이밍 관례 차이는@map, 늘어난 테이블의 소속은@@schema로 푼다. 관계 상태는(userId, characterId)키의 옆 테이블에 두어 캐릭터 원본을 깨끗하게 지킨다.