2026-10 개정: 이 글은 지금의 플릿에 맞춰 다시 썼다. 스토리·토크룸·캐릭터 챗 3모드와 그 연결 테이블, Neon·Voyage AI 서술을 걷어내고, 1:1 캐릭터 챗 단일 구조와 Render Postgres, Gemini 임베딩,
@plit/shared워크스페이스 기준으로 바꿨다.
도입
플릿(Plit)은 AI 캐릭터와 1:1 로 대화하는 AI 채팅 플랫폼이다. 사용자는 캐릭터를 골라 그 캐릭터의 페르소나로만 이어지는 대화를 한다. 호감도와 기억은 대화에 들어온 뒤에 발견하는 층이다. 캐릭터는 여성향(남성 캐릭터 중심)과 남성향(여성 캐릭터 중심)으로 나뉘고, 어느 쪽을 볼지는 사용자가 고른다. 여러 캐릭터가 한 방에 있는 그룹 채팅은 계획 단계다.
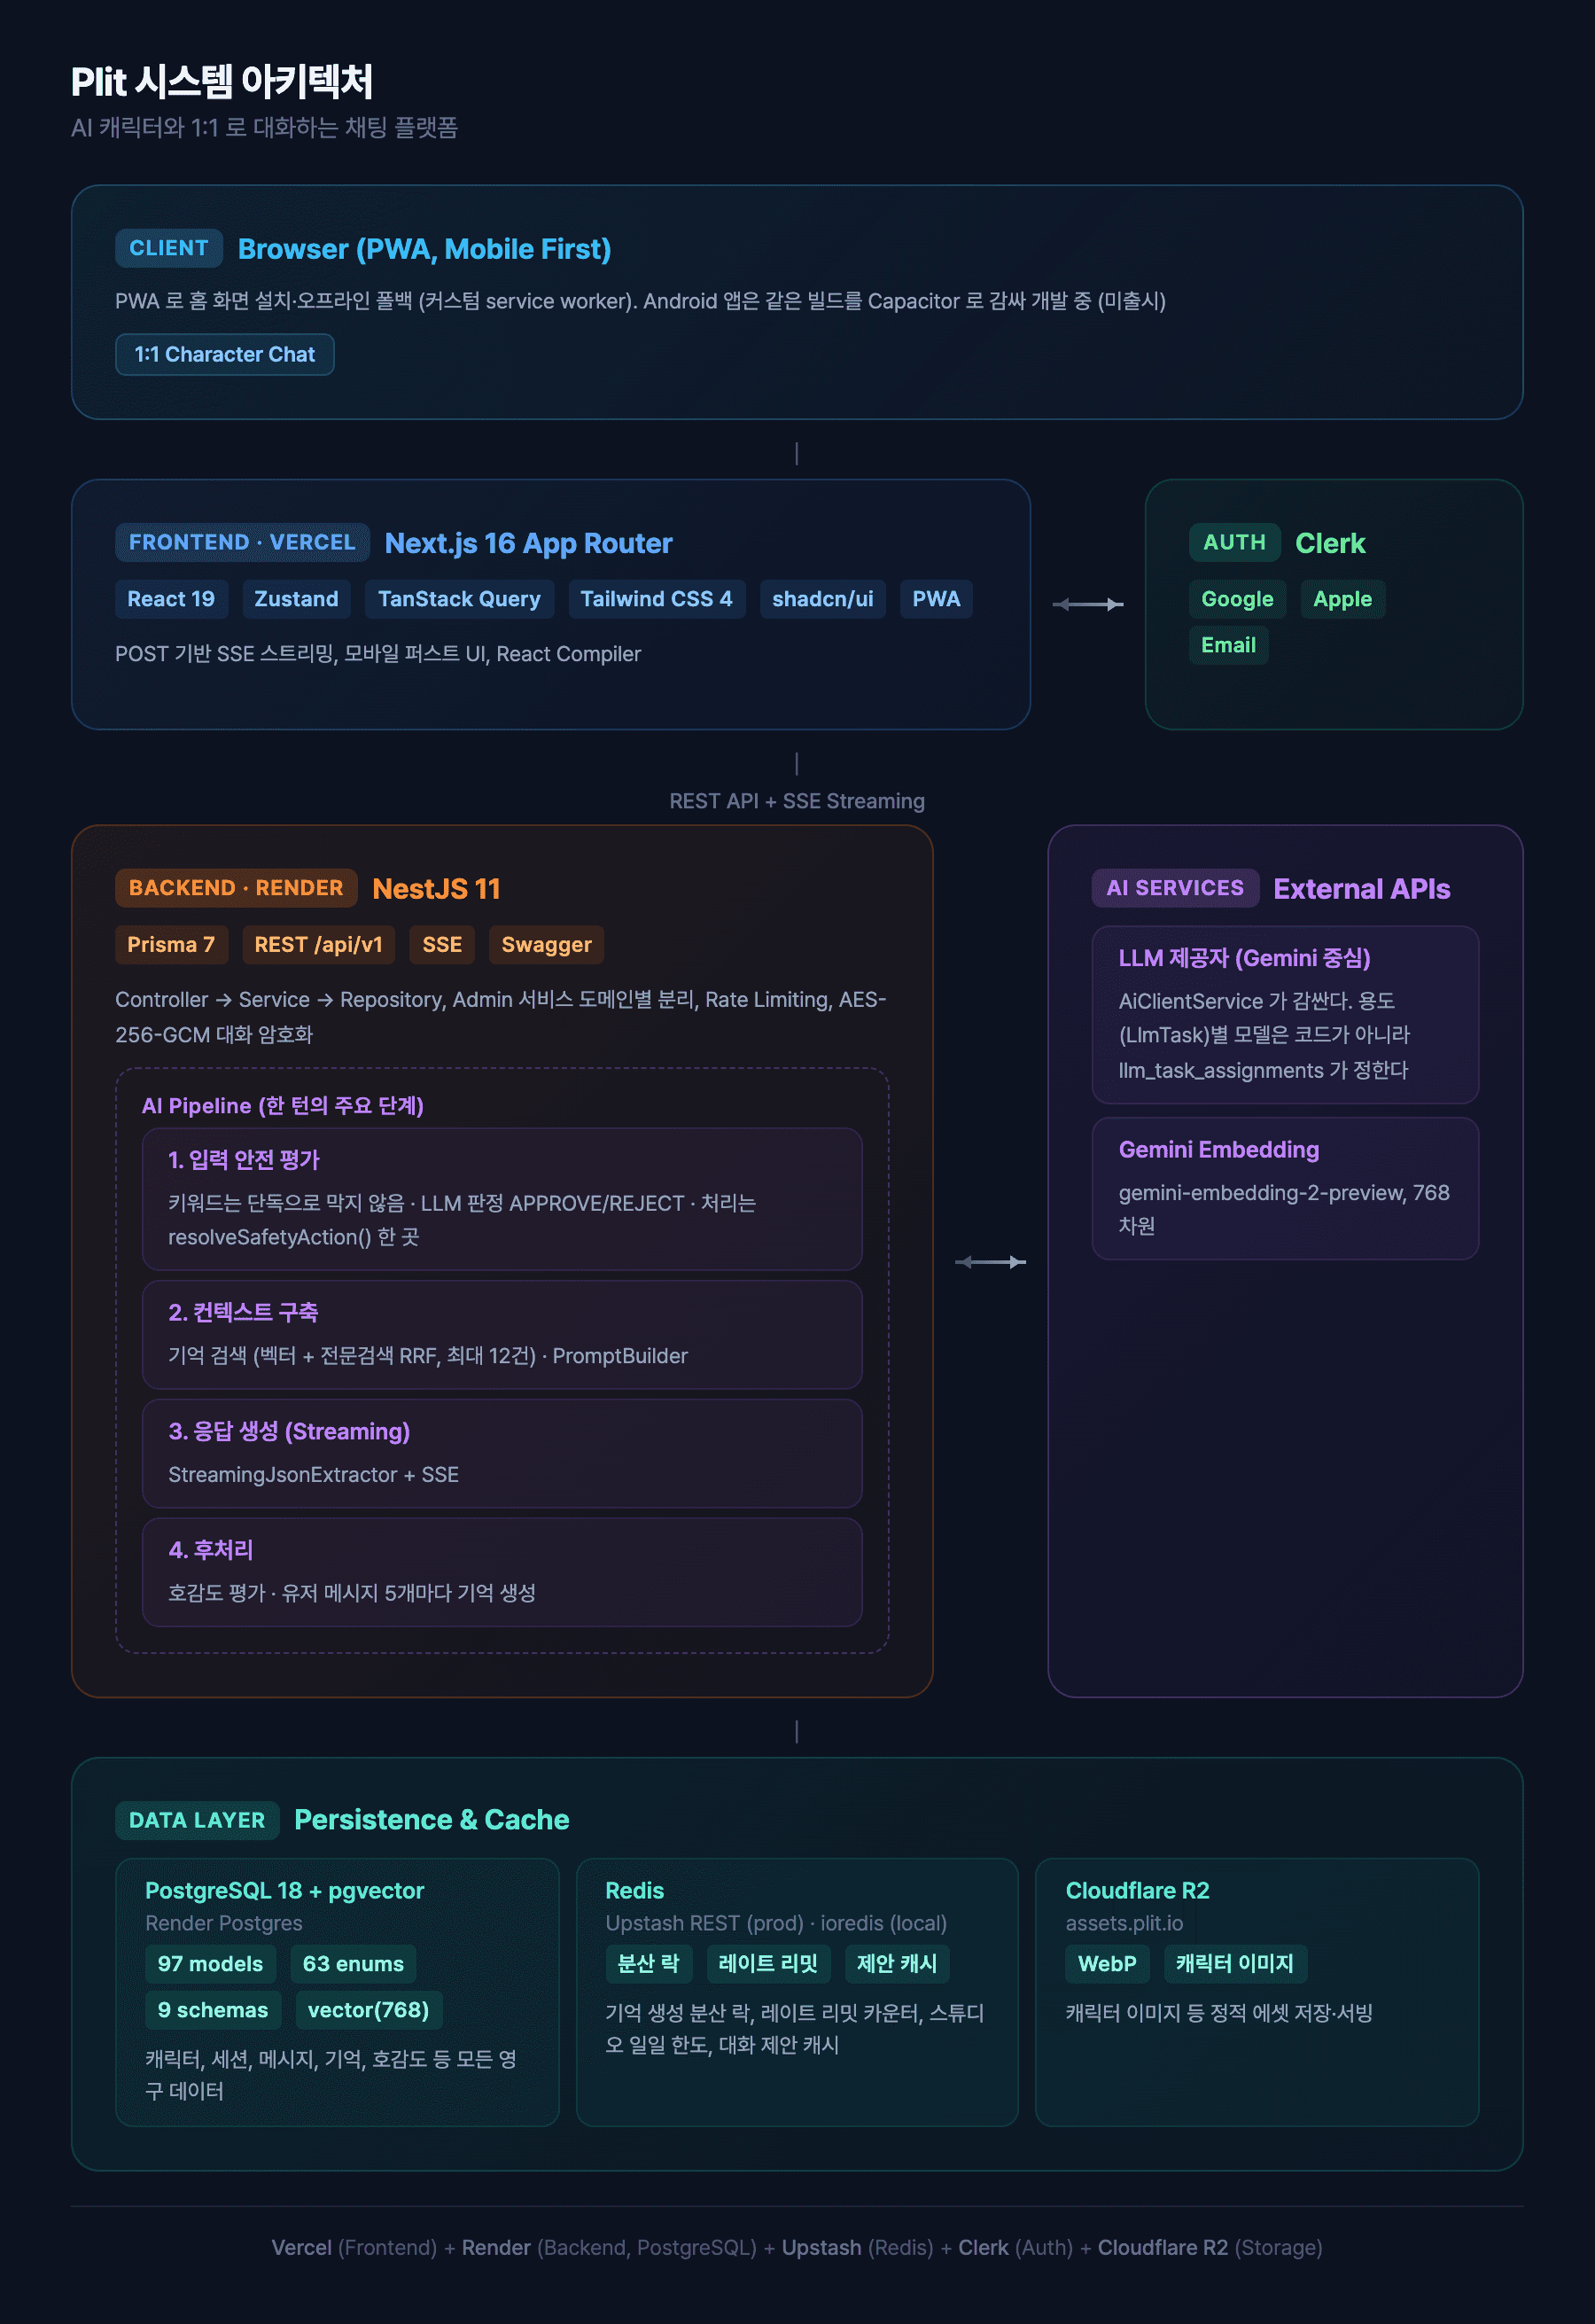
이 아키텍처의 중심은 **운영 가능성(operability)**이다. 기획부터 인프라까지 전 영역을 빠르게 오가야 하는 상황이라, 선택할 때마다 "이 구조를 최소 인원으로 안정적으로 굴릴 수 있나"를 먼저 물었다. 확장은 되되 과하지는 않은 쪽을 골랐다.
이 글은 플릿의 전체 시스템 아키텍처를 다룬다. 인프라 선택, 모노레포 구조, 데이터베이스 설계, 백엔드 모듈 구조, 프론트엔드 아키텍처까지 훑으면서, 각 선택이 어떤 트레이드오프를 거쳐 지금 모습이 됐는지 적었다.
핵심 1: 인프라 선택, 관리형 서비스 조합
인프라를 고를 때 기준은 세 가지였다. 운영 부담이 적을 것, 비용이 예측될 것, 나중에 키울 여지가 있을 것.
| 서비스 | 역할 | 선택 이유 |
|---|---|---|
| Vercel | 프론트엔드 호스팅·CDN·SSR | Next.js 네이티브 지원, Zero-config 배포 |
| Render | 백엔드 API 서버 + PostgreSQL 18 | render.yaml 하나에 빌드·pre-deploy(마이그레이션)·헬스체크를 적는다 |
| Upstash | Redis (레이트 리밋·분산 락·캐시) | 서버리스, REST 프로토콜 지원, 사용량 기반 과금 |
| Clerk | 인증 (OAuth + JWT) | 구글·애플·이메일 로그인을 코드 수십 줄로 구현 |
| Cloudflare R2 | 이미지 스토리지 | S3 호환 API, egress 비용 없음 |
핵심 원칙: 직접 관리하는 인프라를 최소화한다. DB 백업, SSL 인증서 갱신, 인증 보안 패치처럼 계속 손이 가는 일을 관리형 서비스에 맡기면 제품 개발에 시간을 쓸 수 있다.
그중 Clerk이 개발 시간을 가장 많이 줄여줬다. 구글·애플 OAuth, JWT 발급과 검증, 세션 관리를 직접 짰다면 최소 1-2주는 더 걸렸다. 지금은 프론트엔드를 ClerkProvider로 감싸고 백엔드의 ClerkAuthGuard가 @clerk/backend의 verifyToken()으로 Bearer 토큰을 검증하면 인증은 끝난다.
로컬 개발 환경은 Docker Compose로 PostgreSQL과 Redis만 띄운다:
# docker-compose.yml (발췌)
services:
  postgres:
    image: pgvector/pgvector:pg18    # pgvector 확장 내장
    container_name: plit-postgres
    environment:
      POSTGRES_DB: plit
      POSTGRES_USER: postgres
      POSTGRES_PASSWORD: postgres
    ports:
      - '${POSTGRES_HOST_PORT:-55432}:5432'

  redis:
    image: redis:7-alpine
    container_name: plit-redis
    command: redis-server --appendonly yes
    ports:
      - '${REDIS_HOST_PORT:-56379}:6379'
로컬과 프로덕션의 차이는 환경변수다. DATABASE_URL이 로컬 Docker를 가리키느냐 Render Postgres를 가리키느냐가 DB 쪽 차이의 전부다. Redis 는 접속 방식까지 갈린다. RedisService(backend/src/common/redis/redis.service.ts)는 UPSTASH_REDIS_REST_URL·UPSTASH_REDIS_REST_TOKEN이 있으면 Upstash REST 클라이언트를, 없으면 REDIS_URL로 ioredis TCP 연결을 연다. 호출하는 쪽은 어느 쪽인지 모른다.
핵심 2: 모노레포 구조, 워크스페이스는 쓰고 오케스트레이터는 쓰지 않는다
plit/
├── backend/            # NestJS 11 (port 53001)
├── frontend/           # Next.js 16 (port 53000)
├── packages/shared/    # @plit/shared: 양쪽이 쓰는 enum·상수·타입·한국어 라벨
├── mobile/             # Capacitor 8 Android 셸 (frontend/out 을 감싼다)
├── tools/              # MCP 서버, 부하 테스트, lint 규칙
├── docs/               # SRS, 시스템 설계, 도메인별 문서
├── scripts/            # 게이트·배포 스크립트
├── docker-compose.yml
├── pnpm-workspace.yaml
└── Makefile            # 통합 명령어
pnpm workspaces 로 backend·frontend·mobile·packages/*를 한 저장소에 묶는다. 초기에는 공유 패키지 없이 디렉토리마다 따로 돌렸는데, 백엔드와 프론트가 함께 써야 하는 enum·SSE 이벤트명·에러 코드가 늘면서 @plit/shared로 모았다. 지금은 SSE 이벤트명과 에러 코드(SSE_EVENTS/SSE_ERROR_CODES)도 여기서 나오고 양쪽이 같은 상수를 import 하므로, 이벤트 이름이 백엔드와 프론트에서 따로 갈라질 자리가 없다.
그래도 Turborepo나 Nx 같은 빌드 오케스트레이터는 쓰지 않는다. 의존 관계가 "shared 를 먼저 빌드한다" 하나뿐이라, 순서는 빌드 명령에 직접 적는다:
# render.yaml (발췌)
buildFilter:
  paths:
    - backend/**
    - packages/shared/**
    - pnpm-lock.yaml
    - pnpm-workspace.yaml
buildCommand: pnpm install && pnpm --filter @plit/shared build && cd backend && pnpm build
오케스트레이터가 해 주던 "바뀐 것만 빌드"도 배포 쪽 기능으로 대신한다. Render 는 buildFilter에 걸린 경로가 바뀔 때만 백엔드를 빌드하고, Vercel 은 frontend/vercel.json의 ignoreCommand(scripts/vercel-ignore-build.sh)가 프론트 빌드 입력(frontend/·packages/shared/·lockfile 등)이 그대로인 프리뷰 빌드를 건너뛴다. 프론트의 build 스크립트도 pnpm --filter @plit/shared build로 시작한다.
자주 쓰는 명령어는 Makefile로 묶었다:
# Makefile (주요 명령어)
make setup          # Docker 컨테이너 + 의존성 + 마이그레이션 + 시드
make dev            # 백엔드 dev 서버 시작
make dump-seed      # DB → seed 파일 내보내기
make reset-db       # Drop → create → migrate → seed
백엔드와 프론트엔드가 한 저장소에 있으면 스키마 변경이 어디까지 번지는지 한눈에 보인다. enum 을 바꾸면 packages/shared/src/enums.ts를 고치고 pnpm build:shared를 돌린 뒤 Prisma 스키마와 프론트의 re-export 를 같은 커밋에서 맞춘다.
핵심 3: 데이터베이스 설계, 캐릭터는 독립 엔티티다
스키마는 backend/prisma/schema.prisma 한 파일에 Prisma 모델 97개, enum 63개가 있고, PostgreSQL 스키마 9개(account·content·chat·memory·safety·billing·engagement·ops·public)로 영역을 나눈다. 그 안에서 가장 중요한 결정은 캐릭터를 독립 엔티티로 떼어낸 것이다.
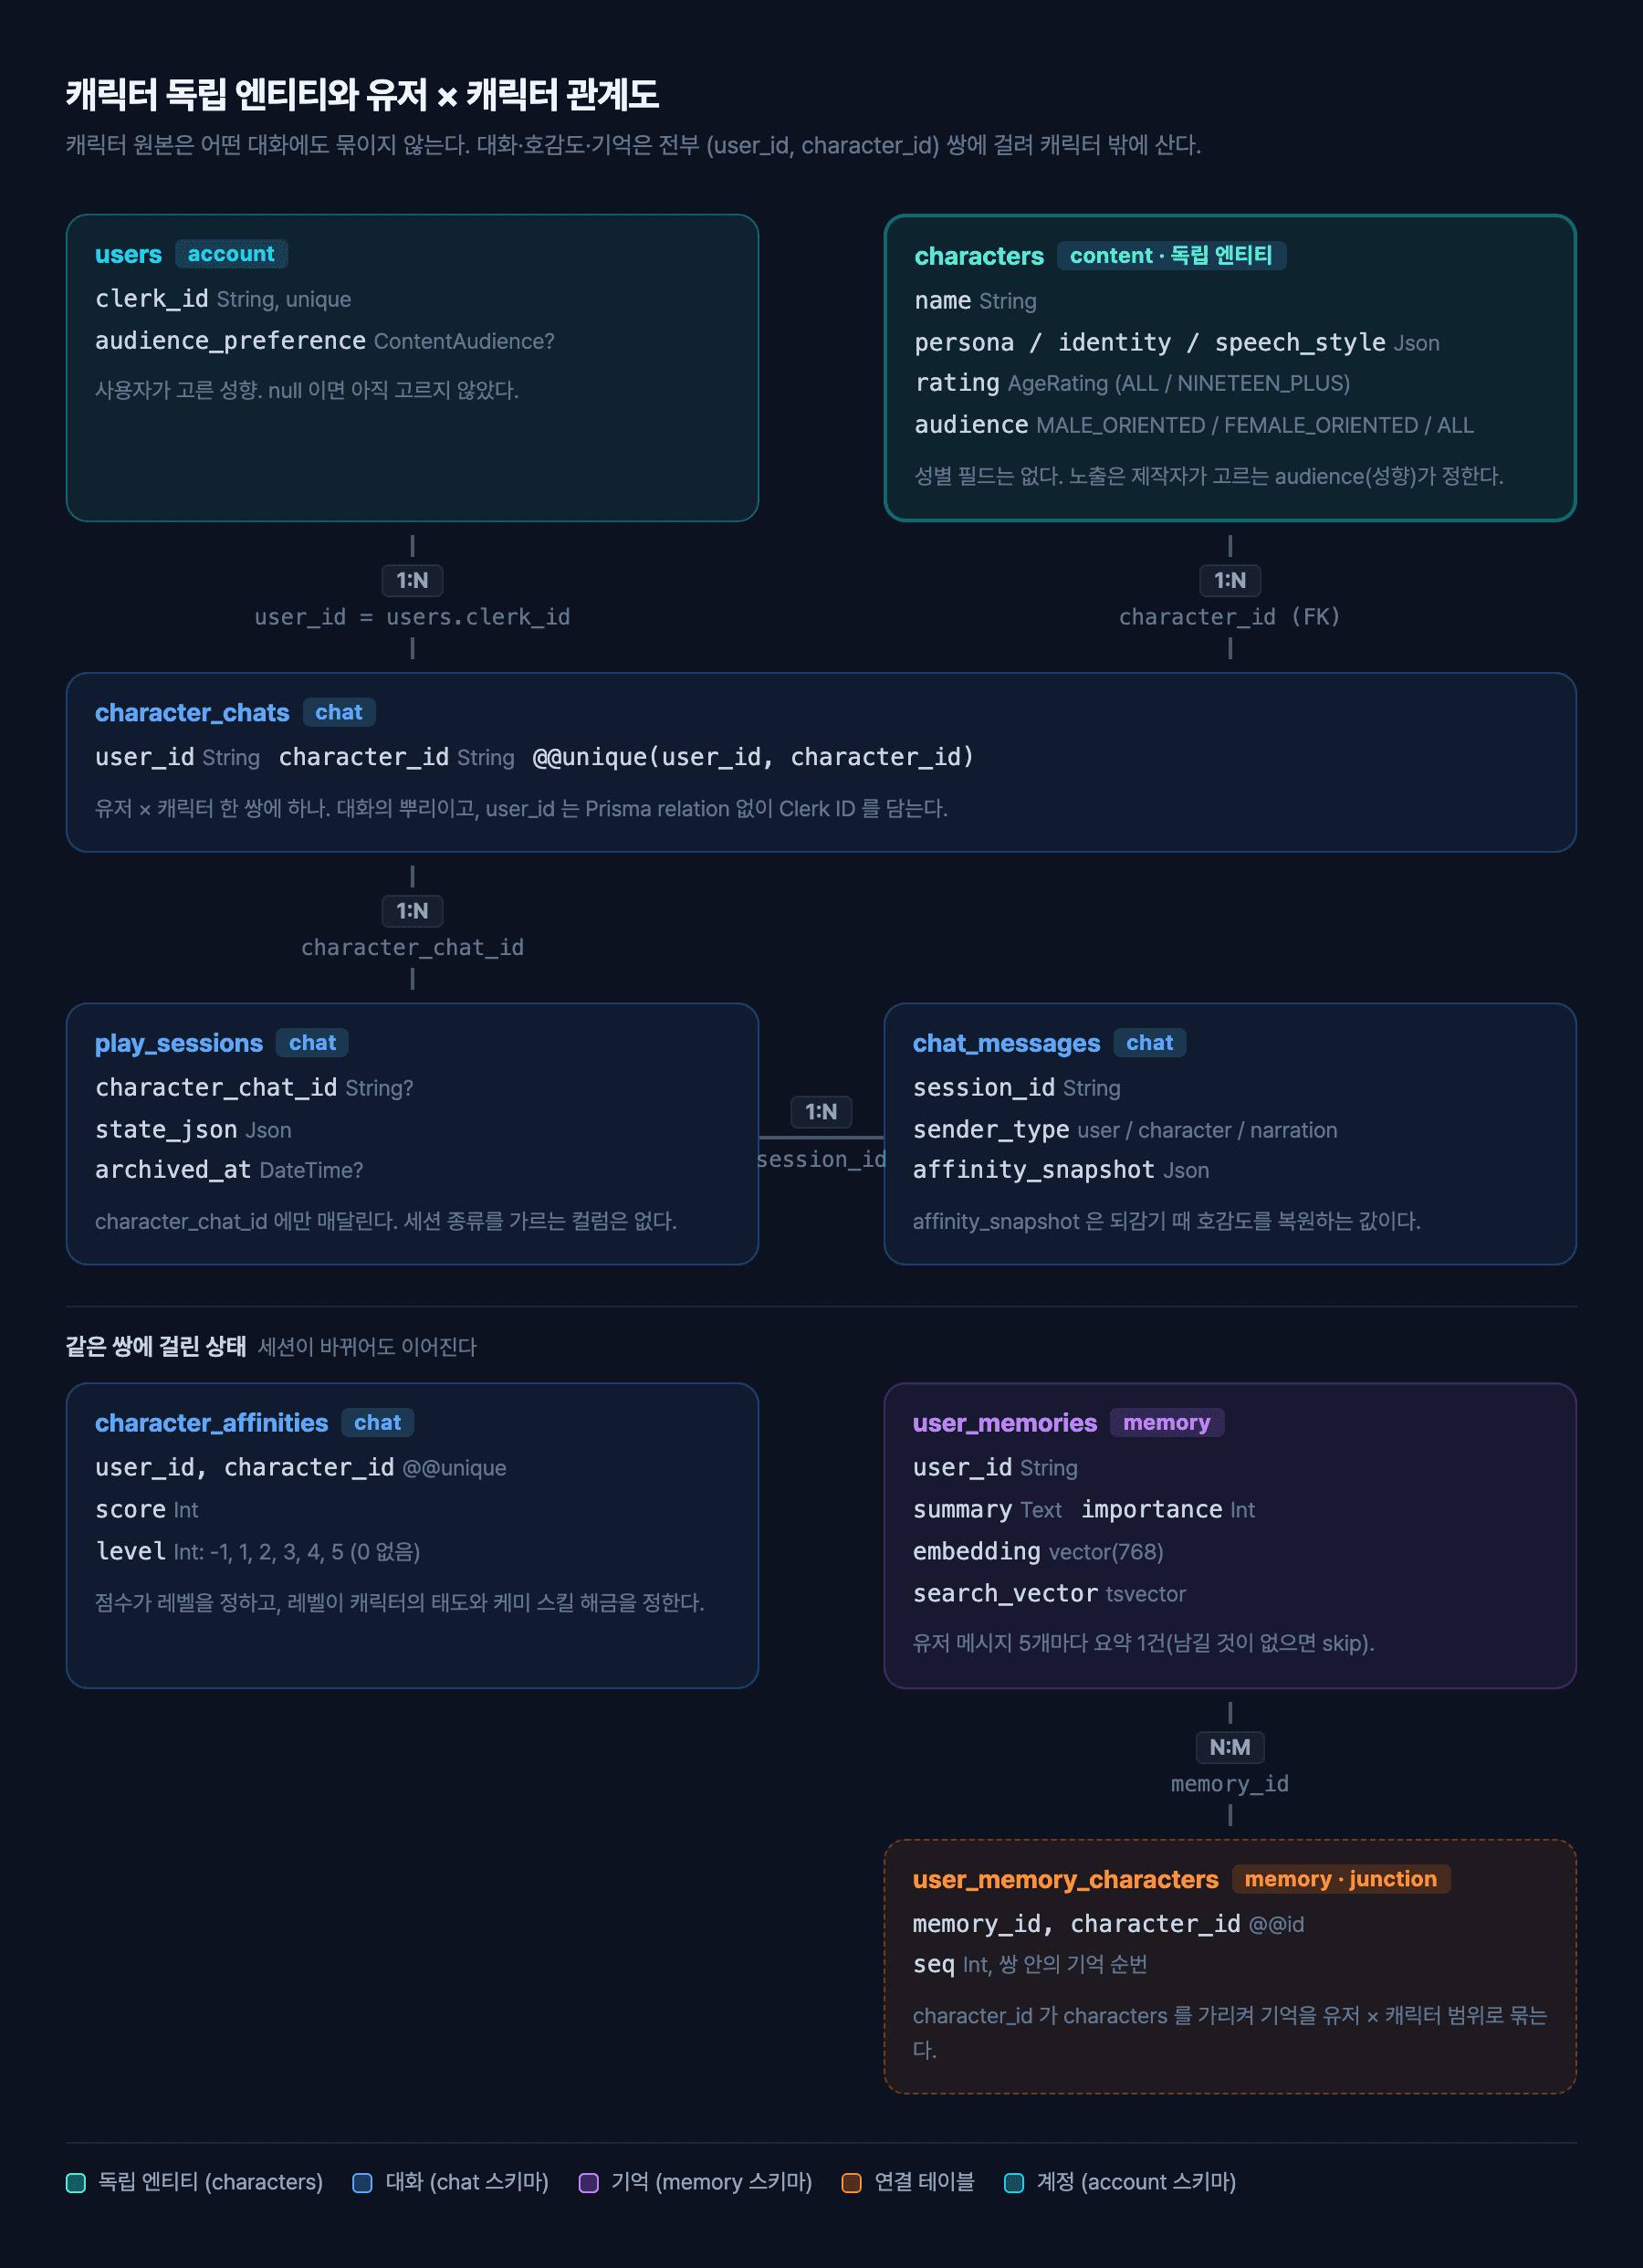
캐릭터 독립성 설계
사람이 저작하는 콘텐츠는 캐릭터와 그 시작 지점(starting_points)뿐이다. 나머지 인사말·나레이션·장면 전환은 미리 써 두지 않고 대화 중에 생성한다. 그래서 캐릭터 원본은 특정 대화에 묶이지 않아야 하고, 한 사용자와 그 캐릭터 사이의 관계는 캐릭터 밖에 둔다.
// backend/prisma/schema.prisma (발췌, 필드 일부만)
model Character {
  id          String          @id @default(uuid())
  name        String
  persona     Json?           // 런타임은 { personality } 만 읽는다
  identity    Json?           // { backstory, core_traits[], motivation, flaw, archetype }
  speechStyle Json?           @map("speech_style")
  rating      AgeRating       @default(ALL)
  audience    ContentAudience @default(ALL)  // 성향: MALE_ORIENTED / FEMALE_ORIENTED / ALL

  characterChats CharacterChat[]
  affinityScores CharacterAffinity[]

  @@map("characters")
  @@schema("content")
}

// 유저 × 캐릭터 관계: 캐릭터 밖에 둔다
model CharacterChat {
  id          String        @id @default(uuid())
  userId      String        @map("user_id")
  characterId String        @map("character_id")
  sessions    PlaySession[]

  @@unique([userId, characterId])
  @@map("character_chats")
  @@schema("chat")
}

// 세션은 character_chat_id 에만 매달린다. 세션 종류를 가르는 컬럼은 없다
model PlaySession {
  id              String  @id @default(uuid())
  characterChatId String? @map("character_chat_id")
  stateJson       Json?   @map("state_json")

  @@map("play_sessions")
  @@schema("chat")
}
캐릭터 원본(페르소나, 말투, 등급, 성향)은 characters에 두고, 관계는 (user_id, character_id)로 묶인 테이블들이 따로 든다. character_chats가 대화의 뿌리이고, 호감도는 character_affinities, 캐릭터가 이 사용자에 대해 아는 것은 character_user_profiles·character_user_facts에 산다. 캐릭터에는 성별 필드가 없다. 성별은 캐릭터 설정 글 안에 쓰고, 노출은 제작자가 반드시 고르는 audience(성향)가 정한다.
처음에는 같은 캐릭터를 스토리·토크룸 같은 여러 콘텐츠에 붙이려고 story_characters·talk_room_characters 연결 테이블을 뒀다. 제품을 1:1 캐릭터 챗 하나로 좁히면서 그 테이블들과 모드 구분은 사라졌고, 관계 상태를 (user_id, character_id)에 거는 구조만 남았다. 캐릭터 원본을 처음부터 콘텐츠와 떼어 둔 덕에, 모드를 걷어낼 때 캐릭터 쪽 설계는 바꿀 이유가 없었다.
JSONB로 유연하게 상태 저장하기
틀을 정하기 어려운 데이터는 JSONB로 받았다:
PlaySession.stateJson: 플레이어 이름, 현재 장소, 유휴 넛지 기록 등 세션 런타임 상태ChatMessage.affinitySnapshot: 메시지 시점의 호감도 스냅샷. 되감기(rewindToMessage)가 이 값으로 호감도를 복원한다Character.identity: 배경·핵심 특성·동기·결함처럼 AI 프롬프트에 주입되는 구조화된 설정Character.speechStyle: 말투 설정. 처음엔personaJSON 안에 있다가 독립 컬럼으로 뺐고,persona에는 런타임이personality만 읽는 레거시 키가 남아 있다
pgvector로 하는 시맨틱 기억 검색
기억은 세션이 아니라 사용자 × 캐릭터 단위다. UserMemory(memory 스키마)에 요약과 임베딩을 두고, 어느 캐릭터와의 기억인지는 UserMemoryCharacter가 잇는다.
// backend/prisma/schema.prisma (발췌, 필드 일부만)
model UserMemory {
  id           String                      @id @default(uuid())
  userId       String                      @map("user_id")
  summary      String                      @db.Text
  importance   Int                         @default(5)
  embedding    Unsupported("vector(768)")?
  searchVector Unsupported("tsvector")?    @map("search_vector")
  characters   UserMemoryCharacter[]

  @@map("user_memories")
  @@schema("memory")
}
- 그 사용자와 캐릭터 사이에 유저 메시지가 5개 쌓일 때마다 요약을 만든다(
MEMORY_GENERATION_THRESHOLD = 5). 이 창은 세션 경계를 넘어 센다. 남길 것이 없으면 모델이skip을 돌려주므로, 5개가 곧 기억 1건은 아니다. - 임베딩은
gemini-embedding-2-preview로 만든 768차원 벡터다. - 턴마다 최대 12건을 프롬프트에 넣는다. 벡터 검색과 전문 검색(
tsvector) 결과를 RRF 로 합치고, 그중 2칸은 중요도 높은 기억 몫으로 따로 둔다(IMPORTANCE_RESERVED_SLOTS = 2).
Prisma에서 pgvector는
Unsupported타입으로 선언한다. 벡터 연산(<=>)은 repository 안의 Raw SQL로 짜야 하지만 나머지 CRUD는 Prisma가 맡으니 크게 불편하지 않다. 함정이 하나 있다. Prisma 는 이 컬럼 위의 HNSW 인덱스를 스키마로 표현하지 못해서migrate dev가 매번 그 인덱스를 지우는 SQL 을 끼워 넣는다. 그래서 커밋 전과 pre-deploy 에서check-vector-indexes로 인덱스가 살아남는지 검사한다.
핵심 4: 백엔드 모듈 구조, God Service의 실패와 개선
NestJS 11 백엔드는 Controller → Service → Repository → Prisma 순서를 따른다. 쿼리는 <module>/repositories/ 안의 repository 가 쓰고, 서비스가 PrismaService를 직접 주입하는 것은 $transaction으로 트랜잭션 경계를 열 때뿐이다. 이 규칙은 단계적으로 도입하는 중이라 아직 서비스가 Prisma 를 직접 쓰는 모듈도 남아 있다.
backend/src/                (주요 디렉토리만)
├── admin/              # 어드민 전 기능 (도메인별 서비스로 분리)
├── ai-pipeline/        # 한 턴의 처리: 안전 평가, 기억 검색, 응답 생성, 후처리
├── affinity/           # 호감도 (-1, 1~5 레벨) + 케미 스킬 해금
├── auth/               # Clerk 토큰 검증 (ClerkAuthGuard)
├── chat/               # 채팅 메시지 + SSE 스트리밍
├── characters/         # 캐릭터 조회·이미지
├── content-safety/     # 저장 텍스트 심사, 블랙리스트 키워드 관리
├── gems/               # 젬 지갑·거래
├── sessions/           # 캐릭터 챗 세션 생성·조회·리셋
├── stories/            # 홈 탐색·추천 (디렉토리명만 옛 이름이다)
├── studio/             # 제작자용 캐릭터 저작
├── common/             # 공유 인프라 (prisma, redis, storage, crypto, ai-client ...)
└── app.module.ts
AI 파이프라인은 한 턴을 대략 이 순서로 처리한다. 입력 안전 평가 → 컨텍스트 구축(기억 검색, 프롬프트 조립) → 응답 생성(스트리밍) → 출력 평가 → 후처리(호감도 평가, 기억 생성). 안전 쪽은 키워드 블랙리스트가 단독으로 막지 않고, LLM 평가기가 APPROVE/REJECT만 내며, 그 판정이 무엇을 하는지는 resolveSafetyAction()(backend/src/ai-pipeline/safety-policy.ts) 한 곳이 정한다. 출력 평가는 응답을 보낸 뒤에 돌고, ENABLE_OUTPUT_SAFETY_BLOCKING=true가 아니면 응답을 막지 않는다(prod 에서는 꺼져 있다). 어떤 코드 경로도 사용자를 자동으로 정지시키지 않는다. 제재는 관리자가 기간과 사유를 적어 직접 건다.
Anti-Pattern 경험: AdminService 분리
처음에는 AdminService 하나에 콘텐츠 CRUD, 세션 관리, 콘텐츠 안전 로직을 전부 넣었다. 200줄을 넘기자 어떤 메서드가 어디 있는지 찾는 것부터 일이 됐고, 한 도메인을 고치면 다른 도메인의 import가 깨지는 일이 반복됐다.
God Service를 도메인별 서비스로 쪼갰고, 그 규칙이 지금까지 이어져 admin/에는 admin-*.service.ts 서비스가 53개, 컨트롤러가 43개 있다. 일부만 보면 이렇다:
admin/                              (일부)
├── admin.service.ts                # 대시보드 통계만 담당
├── admin-character.service.ts      # Character CRUD
├── admin-session.service.ts        # Session 조회·삭제
├── admin-user.service.ts           # User 목록·역할 변경
├── admin-gem.service.ts            # 젬 트랜잭션·잔액
├── admin-content-safety.service.ts # 블랙리스트·안전 로그
├── admin-content-io.service.ts     # 콘텐츠 Export/Import
├── admin-subscription.service.ts   # 구독·프로모 코드
├── admin-llm-model.service.ts      # LLM 모델 카탈로그·용도별 배정
├── admin-user-lookup.service.ts    # Clerk 유저 조회 (공유 헬퍼)
└── repositories/                   # 어드민 쿼리
규칙은 하나다. 새 어드민 기능을 기존 서비스에 덧붙이지 않고, 서비스 파일이 200줄을 넘으면 분리를 검토한다. 컨트롤러도 처음에는 AdminController 하나에 서비스를 주입해 넘겼지만, 지금은 도메인마다 따로 둔다.
repository 쪽에도 규칙이 하나 붙었다. 트랜잭션 안에서 불릴 수 있는 메서드는 마지막 인자로 tx를 받는다:
// backend/src/affinity/repositories/affinity.repository.ts (발췌)
async findAffinity(
  userId: string,
  characterId: string,
  tx?: Prisma.TransactionClient,
): Promise<CharacterAffinity | null> {
  const db = tx ?? this.prisma;
  return db.characterAffinity.findUnique({
    where: { userId_characterId: { userId, characterId } },
  });
}
tx를 넘기지 않으면 각 호출이 별도 트랜잭션으로 돈다. 컴파일도 테스트도 통과한 채 원자성만 사라지므로, 시그니처로 강제한다.
글로벌 모듈
PrismaModule과 RedisModule은 @Global()로 등록해서 어느 모듈에서든 import 없이 주입받는다. 같은 방식으로 AiClientModule·EmbeddingModule·StorageModule 등 공통 인프라 모듈도 전역으로 둔다. Prisma 7의 @prisma/adapter-pg 드라이버 어댑터를 쓰고, 생성된 클라이언트는 src/generated/prisma/에 떨어진다(gitignore 대상).
AI 호출부는 모델명을 모른다. aiClient.generateText({ task: LlmTask.X })처럼 용도만 넘기면, AiClientService가 감싼 제공자(Gemini·Claude·OpenAI) 중 어느 모델을 쓸지를 llm_task_assignments 테이블이 정한다. 모델 교체는 배포 없이 어드민 화면에서 한다.
핵심 5: 프론트엔드 아키텍처, 모바일 퍼스트 PWA
Next.js 16 App Router + React 19 + React Compiler(next.config.ts의 reactCompiler: true) 조합이다.
상태 관리 전략
상태는 서버 상태와 클라이언트 상태로 갈라놓았다:
| 구분 | 도구 | 용도 |
|---|---|---|
| 서버 상태 | TanStack Query | API 데이터 페칭·캐싱·무효화 |
| 채팅 상태 | Zustand (chatStore) | 메시지, SSE 스트리밍, 전송·취소·되감기 |
| UI 상태 | Zustand (chatUIStore) | 모달 토글, 스크롤 버튼, 자동 모드, 호감도 게이지 표시 |
chatStore와 chatUIStore를 따로 둔 데에는 이유가 있다. 채팅 로직(메시지 전송, SSE 처리, 되감기)은 비동기 사이드 이펙트가 많은 반면, UI 상태(모달 열림/닫힘, 선택된 캐릭터)는 순수한 setter다. 둘을 한 store에 넣으면 필요 없는 리렌더링이 따라온다.
POST 기반 SSE 스트리밍
브라우저에 내장된 EventSource는 GET만 지원한다. 메시지 본문을 실어 보내야 하는 채팅에는 쓸 수 없다. 그래서 fetch + ReadableStream으로 POST 기반 SSE를 직접 구현했다:
// frontend/src/lib/sse.ts: sendMessageSSE (핵심 구조만)
res = await fetch(`${apiUrl}/sessions/${sessionId}/messages`, {
  method: 'POST',
  headers,                       // Content-Type, Authorization: Bearer <Clerk 토큰>
  body: JSON.stringify(body),
  signal: controller.signal,     // 취소는 AbortController 로
});

const reader = res.body.getReader();
const decoder = new TextDecoder();
let buffer = '';

while (true) {
  const { done, value } = await reader.read();
  if (done) break;

  buffer += decoder.decode(value, { stream: true });
  const lines = buffer.split('\n');
  buffer = lines.pop() || '';      // 덜 온 줄은 다음 조각과 합친다
  // event: / data: 줄을 파싱해 onEvent(event, data) 로 넘긴다
}
스트림이 아예 열리지 않은 실패는 상태 코드가 유일한 단서라(429 는 한도 소진), onStreamEnd('fetch_error', res.status)로 따로 넘긴다.
모바일 퍼스트
UI는 전부 모바일 뷰포트를 먼저 놓고 설계한다. 뷰포트 높이는 dvh 단위로 재고, safe area를 감안한 패딩을 넣는다. PWA 는 커스텀 service worker(frontend/public/sw.js)로 홈 화면 설치, 오프라인 폴백, 푸시를 붙였다. 예외는 제작자용 스튜디오(/studio/*)로, 여기는 PC 사용자를 먼저 놓는다.
앱은 별도 코드베이스로 만들지 않는다. pnpm --filter frontend build:native가 같은 Next.js 앱을 정적 파일(frontend/out)로 내보내고, mobile/의 Capacitor 8 Android 셸이 그 디렉토리를 WebView 로 감싼다. 빌드 시점 분기는 IS_NATIVE_BUILD, 네이티브 플러그인 호출은 isNativeRuntime()(둘 다 frontend/src/lib/platform.ts)을 거친다. Android 앱은 개발 중이고 아직 출시 전이라, 그때까지는 PWA 가 모바일의 주력 채널이다. iOS 는 Android 다음이다.
기술 스택 정리
| 영역 | 기술 | 버전/비고 |
|---|---|---|
| 프론트엔드 | Next.js (App Router) | 16, React 19, React Compiler |
| 백엔드 | NestJS | 11, /api/v1 전역 prefix, Swagger |
| ORM | Prisma | 7.x, @prisma/adapter-pg 드라이버 어댑터 |
| 데이터베이스 | PostgreSQL + pgvector (Render) | 18, 시맨틱 기억 검색 |
| 캐시/락 | Redis | prod 는 Upstash REST, 로컬은 Redis 7 컨테이너. 레이트 리밋·기억 생성 분산 락·대화 제안 캐시 |
| 인증 | Clerk | 구글·애플·이메일 OAuth + JWT |
| AI 텍스트 생성 | Gemini 중심 (AiClientService) | 용도별 모델은 llm_task_assignments가 정한다 |
| 임베딩 | Gemini | gemini-embedding-2-preview, vector(768) |
| LLM 관측 | Langfuse (self-hosted) | 프롬프트 관리·트레이스 |
| 스토리지 | Cloudflare R2 | S3 호환, WebP 이미지 |
| 호스팅 | Vercel + Render | 프론트/백 분리 배포 |
| 모바일 앱 | Capacitor 8 | Android 셸, 개발 중 |
| UI | shadcn + Tailwind CSS 4 | @base-ui/react 프리미티브 |
| 상태 관리 | Zustand + TanStack Query | 클라이언트/서버 상태 분리 |
| 애니메이션 | Framer Motion | |
| 에러 수집 | Sentry SDK → self-hosted GlitchTip | 프론트엔드 + 백엔드 |
| 패키지 매니저 | pnpm workspaces | Node.js v24+ |
정리: 아키텍처 핵심 판단 7가지
-
관리형 서비스를 적극 활용한다. 인증(Clerk), DB(Render Postgres), 캐시(Upstash), 스토리지(R2)를 맡기고 직접 운영할 인프라를 줄여야 제품 개발에 시간이 남는다.
-
워크스페이스는 쓰되 오케스트레이터는 필요할 때 도입한다. 공유 코드는
@plit/shared패키지 하나로 모으고, 빌드 순서는 빌드 명령에, 변경 감지는 RenderbuildFilter와 VercelignoreCommand에 맡긴다. 지금 규모에서 Turborepo는 오버헤드다. -
엔티티 독립성을 초기에 설계한다. 캐릭터 원본과 사용자별 관계 상태를 처음부터 떼어 둔 덕에, 제품을 1:1 캐릭터 챗 하나로 좁힐 때 걷어낸 것은 모드와 연결 테이블뿐이었다. 관계는
(user_id, character_id)에, 세션은character_chat_id에 건다. -
God Service가 되기 전에 분리한다. 200줄 규칙을 두고, 넘기기 전에 도메인별로 쪼갠다. 미루면 import 정리에만 반나절이 든다. 쿼리는 repository 로 모으고, 트랜잭션에 낄 수 있는 메서드는
tx를 받게 한다. -
JSONB는 스키마 변경 비용을 줄여준다.
stateJson,affinitySnapshot,identity처럼 구조가 자주 바뀌는 데이터는 JSONB로 유연하게 받는다. 다만 쿼리 성능이 걸리는 필드는 정규 컬럼으로 뺀다. -
서버 상태와 클라이언트 상태를 명확히 분리한다. TanStack Query(서버)와 Zustand(클라이언트)의 경계를 그어두면 "이 데이터는 어디서 관리하지?" 하는 고민이 사라진다.
-
모바일 퍼스트 + PWA로 시작하고, 앱은 같은 빌드를 감싼다. PWA로 모바일 사용자를 먼저 붙잡고, Android 앱은 같은 Next.js 앱의 정적 빌드를 Capacitor 로 감싸 두 번째 코드베이스를 만들지 않는다.
dvh, safe area, 터치 타겟만 챙기면 네이티브에 준하는 경험이 나온다.